


Blog
Wie klein kann der Serverraum werden? Ich war auf der GTC Berlin, um eine Antwort zu finden

Mein Vater erzählte mir früher oft von der Computerarbeit an der Universität. Er stanzte sein Programm auf Lochkarten, gab den Stapel ab und wartete über Nacht darauf, dass es lief. Gab es einen Kompilierungsfehler, korrigierte er die Karte und stellte sich erneut an – ein einziger Tippfehler konnte ihn also einen ganzen Tag kosten.
An diese Geschichte musste ich im Oktober auf der GTC Berlin denken. Heute spielt sich diese Szene in Forschungslaboren ab: Doktoranden warten auf Zeit an der einen Maschine, die die benötigten Modelle ausführen kann. Was ich in Berlin gesehen habe, ist, dass die Warteschlange kürzer wird, weil die Maschine auf eine Größe schrumpft, die in denselben Raum passt.
Vom Rack zum Rucksack
Jensen Huangs Keynote deckte die gesamte Bandbreite ab. Am einen Ende stehen die KI-Fabriken: Vera Rubin, mit Racks, in denen Dutzende von GPUs wie eine Einheit arbeiten. Er fasste den Fortschritt in einem Satz zusammen: „Im Laufe der letzten 10 Jahre haben wir die KI-Leistung um das Millionenfache gesteigert.“
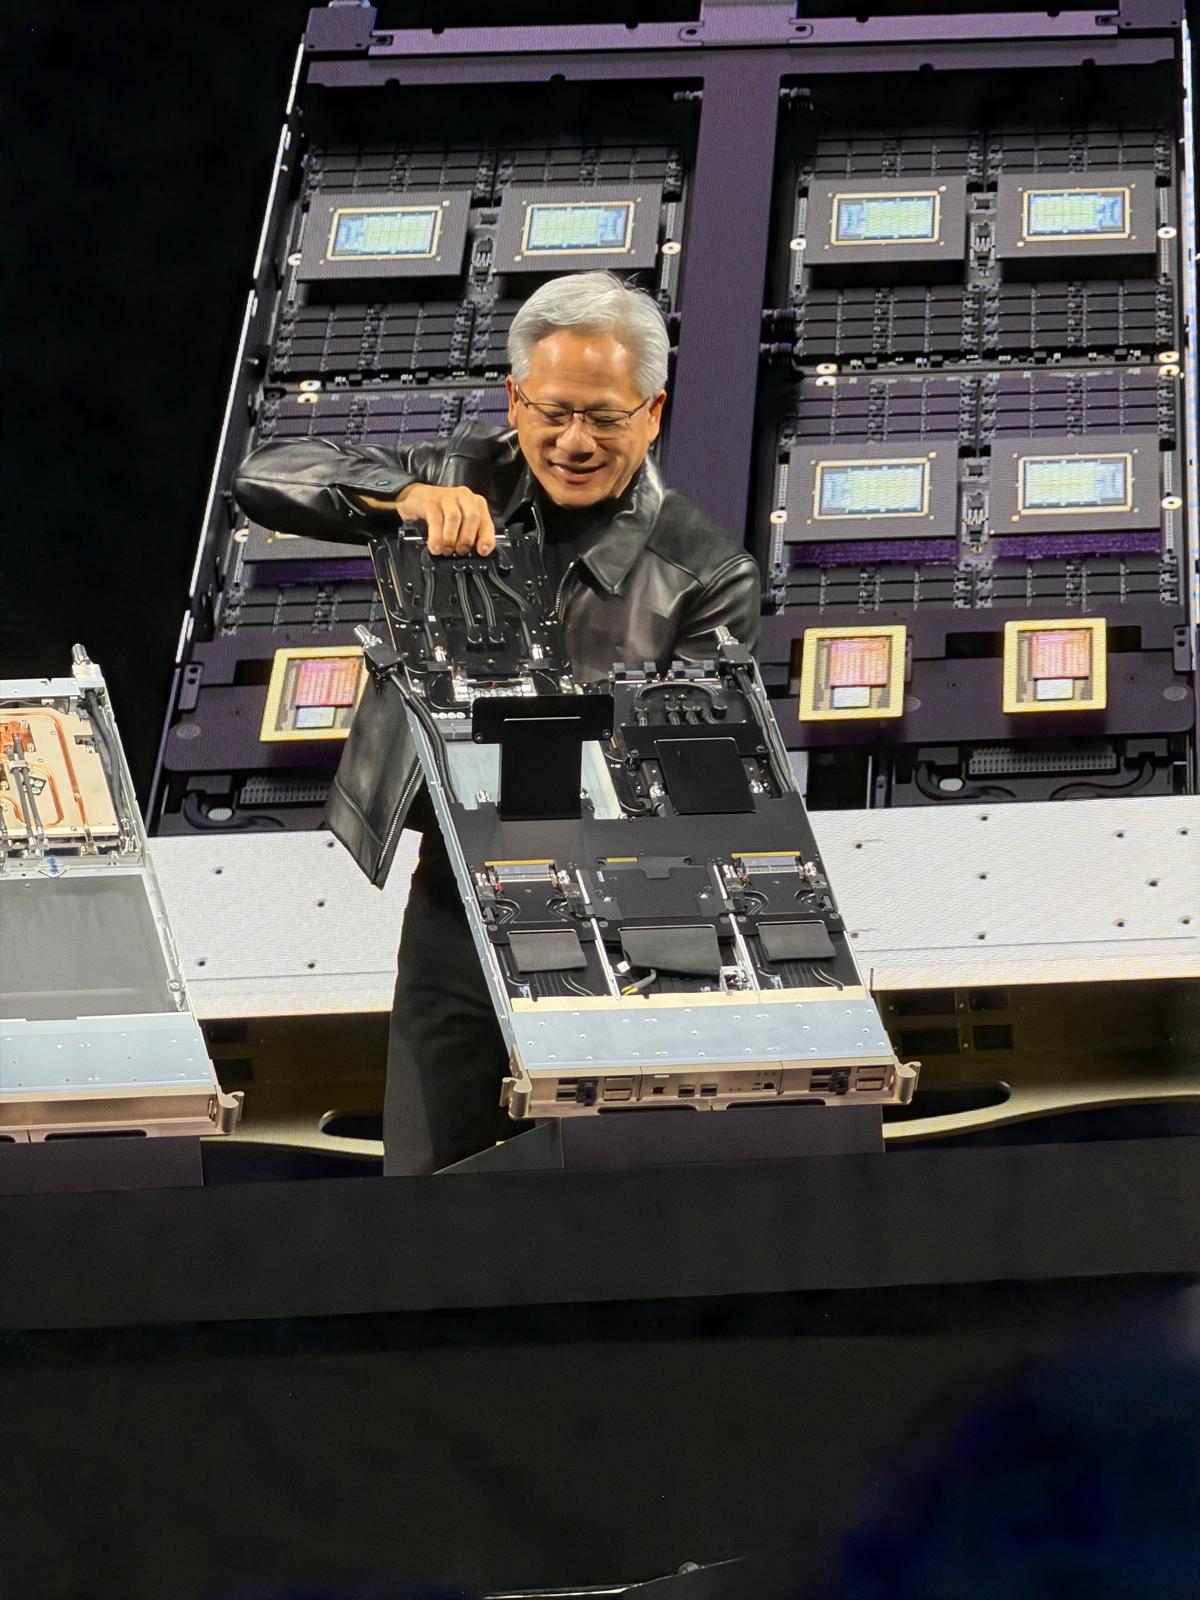 Jensen Huang hält das flüssigkeitsgekühlte Vera Rubin Compute-Tray auf der Bühne der GTC Berlin hoch. Foto von Julian de Ruiter.
Am anderen Ende derselben Keynote hielt er einen Computer hoch, den man tragen kann – das Ende der Skala, das für ein kleines Team oder ein Labor entscheidend ist.
Im hinteren Teil der Ausstellungshalle verdeutlichte eine Demo eines NVIDIA-Ingenieurs den Punkt besser als jede Folie. Zwei Dell-Tower mit DGX-Station-Hardware standen unter einem Holztisch. Daneben ein Schild: Dreißig Entwickler, die gleichzeitig offline arbeiteten. Auf dem Bildschirm baute und veröffentlichte ein Team von dreißig KI-Agenten eine Website ohne Internetverbindung, wobei alles lokal auf diesen zwei Boxen lief. Wie dies abgesichert wurde, verdient einen eigenen Beitrag, aber die unmittelbare Erkenntnis war klar: Die Hardware unter diesem Tisch reichte für ein ganzes Team aus.
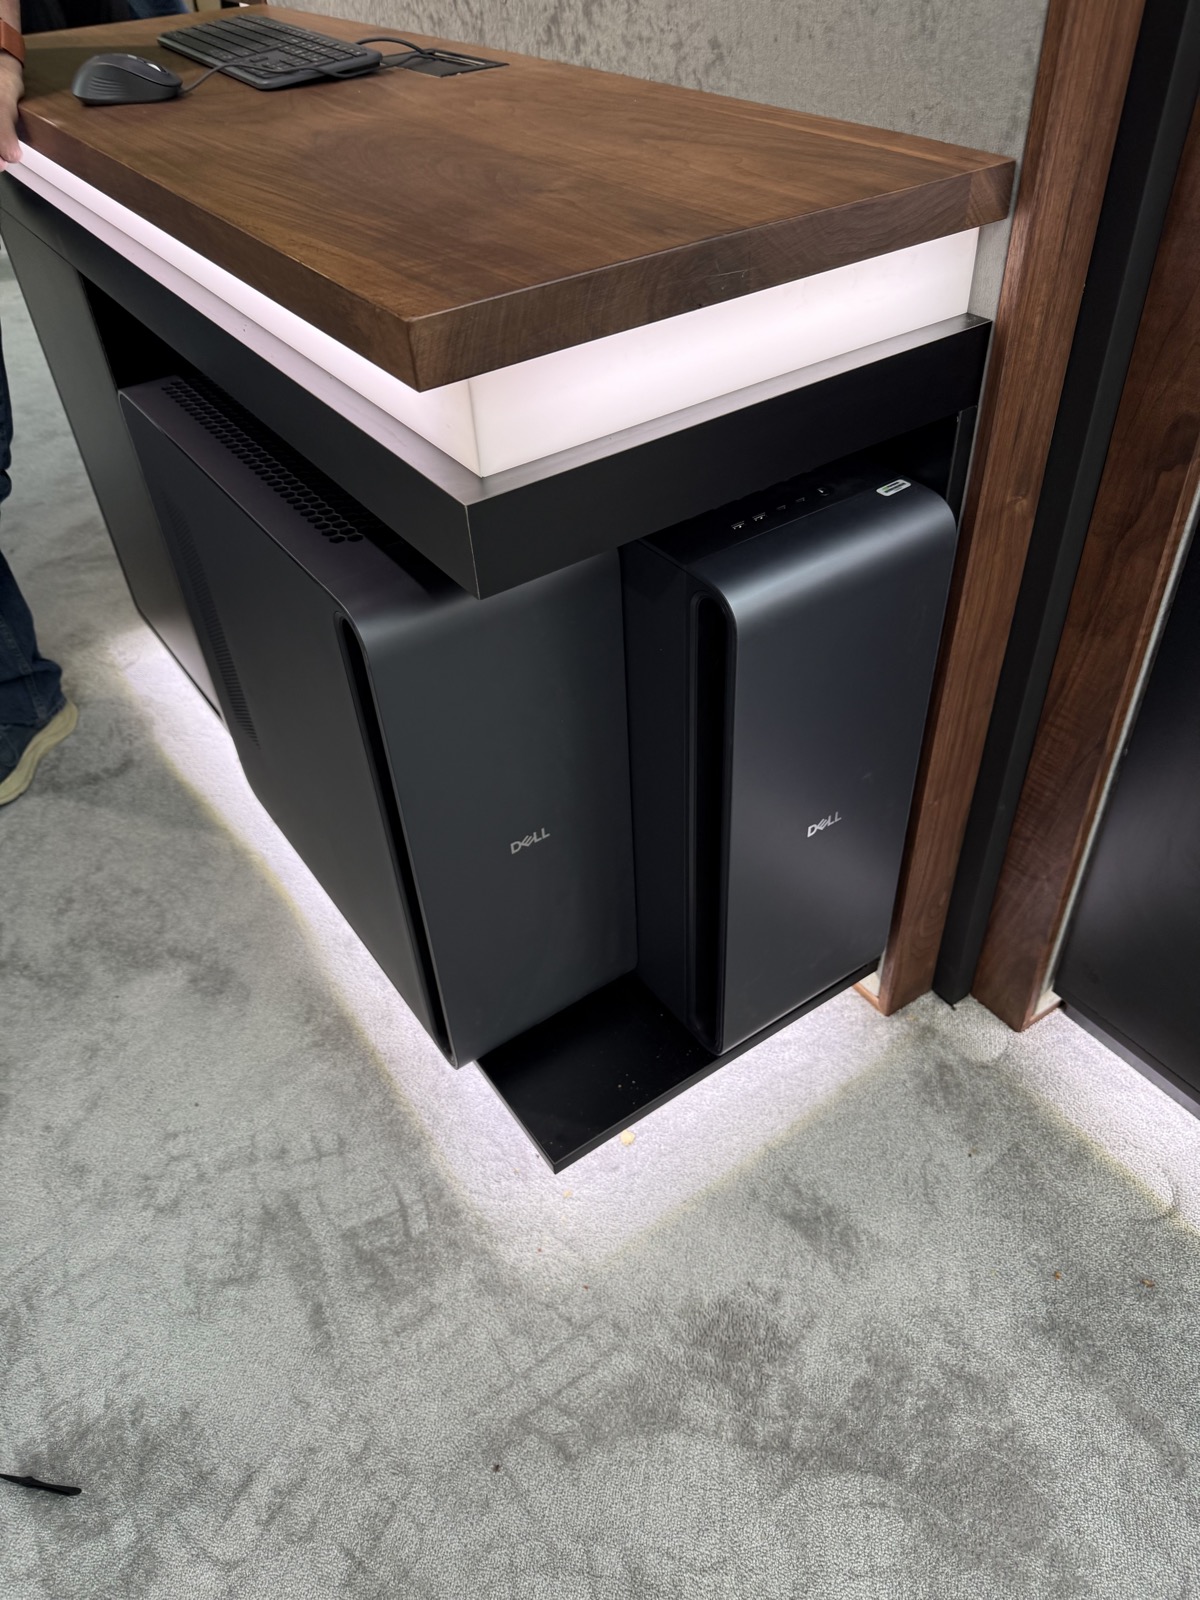 Die zwei DGX-Stationen, auf denen dreißig KI-Agenten offline laufen.
Was ich zuvor sagte
In meinem Newsletter habe ich diese Idee bereits seit mehreren Monaten untersucht.
„Owning your inference“ bedeutet, KI-Modelle auf Maschinen auszuführen, die Sie selbst kontrollieren, anstatt jede Antwort pro Token von einem Cloud-Anbieter zu mieten. Ihre Daten bleiben in Ihrem Gebäude, und nach dem Kauf bestehen Ihre Kosten hauptsächlich aus Strom.
Im September fragte ich, wie klein der Serverraum werden könne. Meine Antwort war, dass ein Cluster aus wenigen leistungsfähigen Maschinen ein ganzes Team gleichzeitig bedienen kann und dass eine gezielte Investition in einen solchen Cluster alle paar Jahre sinnvoller sein kann als der Bau eines kompletten Serverraums. Sie behalten Verfügbarkeit, Souveränität und Datenschutz, solange Sie das System gut verwalten.
Ich habe auch die Haken aufgeschrieben. In der Woche vor dieser Ausgabe stellte ich fest, dass die Hardwarepreise stiegen, statt zu sinken, und dass sich On-Premises-Hardware nur auszahlt, wenn man sie ausgelastet hält. Im Juni war ich sogar noch skeptischer: „Ich glaube nicht, dass der Aufbau eines eigenen GPU-Clusters für die meisten Teams die Lösung ist.“ Beim Gang durch Halle 2 in Berlin sah ich diesen Satz schneller infrage gestellt, als ich erwartet hatte: Ein Cluster aus leistungsfähigen Maschinen ist nun für ein kleines Team in Reichweite. Die Haken sind jedoch nach wie vor real: Die DGX Station für Windows erscheint erst im Dezember, und steigende Speicherpreise treiben die Kosten weiter in die Höhe, sodass die Frage, wie viel man investieren muss, offen bleibt.
Zwei Formen derselben Idee
Die Hardware auf der GTC-Ausstellungsfläche kam in zwei Formen daher.
Im Rucksack. Der RTX Spark ist eine neue Reihe von PCs, die NVIDIA gemeinsam mit Microsoft entwickelt hat: ein Petaflop KI-Rechenleistung und bis zu 128 GB Speicher. Auf der Bühne hielt Jensen ihn in einer Hand und verglich ihn mit der DGX-1, die er 2016 an OpenAI lieferte und die, wie er sagte, die gleichen Spezifikationen hatte und „von zwei Personen nach oben getragen werden musste“.
Geben Sie jedem Mitarbeiter ein Gerät oder stapeln Sie ein paar zu einem Cluster. Auf der Ausstellungsfläche war der „Cluster aus kleinen Maschinen“ aus dem Newsletter als Produkt zu sehen: ein Rack aus DGX Sparks, vernetzt mit eigenen Switches und eigenem Speicher.
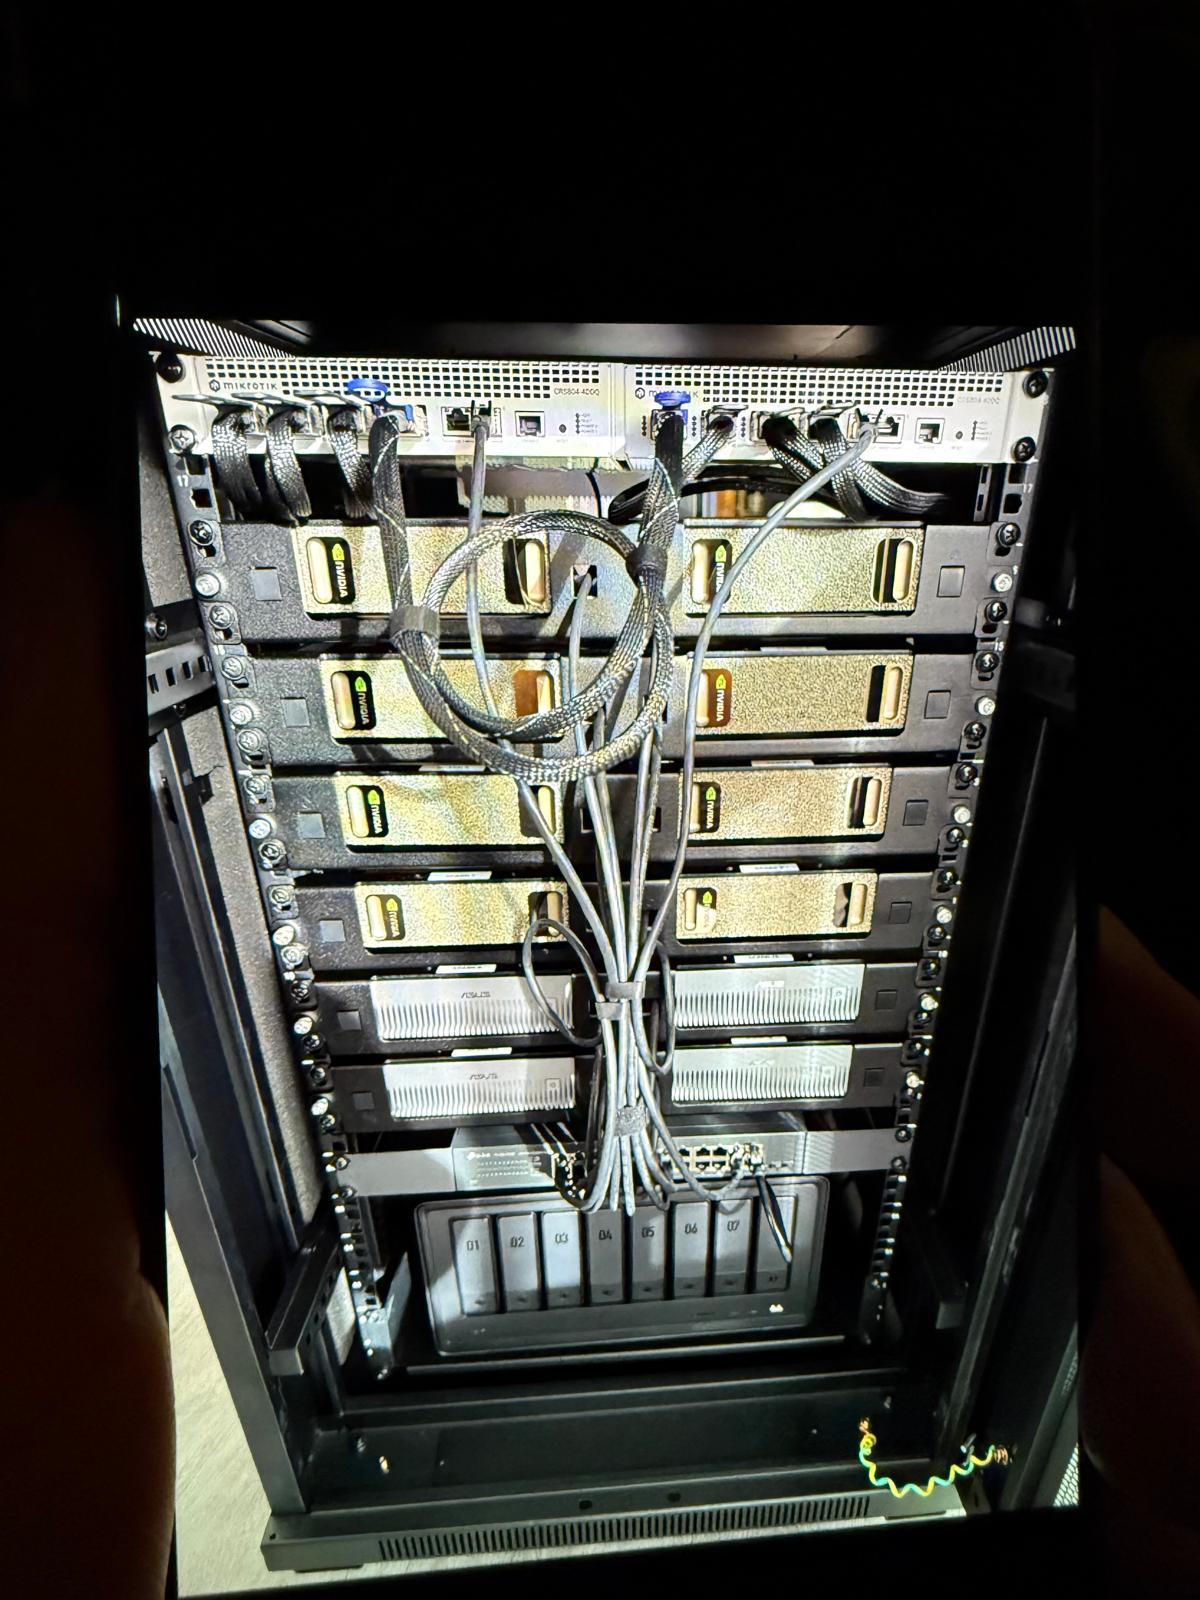 Ein kleiner Cluster in einem Rack: DGX-Spark-Einheiten und ASUS-Ascent-GX10-Systeme, vernetzt mit dedizierten Switches und Speicher.
Im Gebäude. Die DGX Station geht den anderen Weg und bringt alles in einem Deskside-Gehäuse unter: 20 Petaflops FP4-KI-Leistung, wobei zwei Geräte miteinander verbunden werden können, wie in der Demo gezeigt. Am Stand wurde mir gesagt, dass jedes Gerät etwa 100.000 Dollar kostet und ca. 1.800 Watt verbraucht. Für ein kleines Büro, ein Forschungslabor oder eine Universitätsabteilung kauft man damit eine Maschine, die sich alle teilen, ohne dass Daten den Raum verlassen.
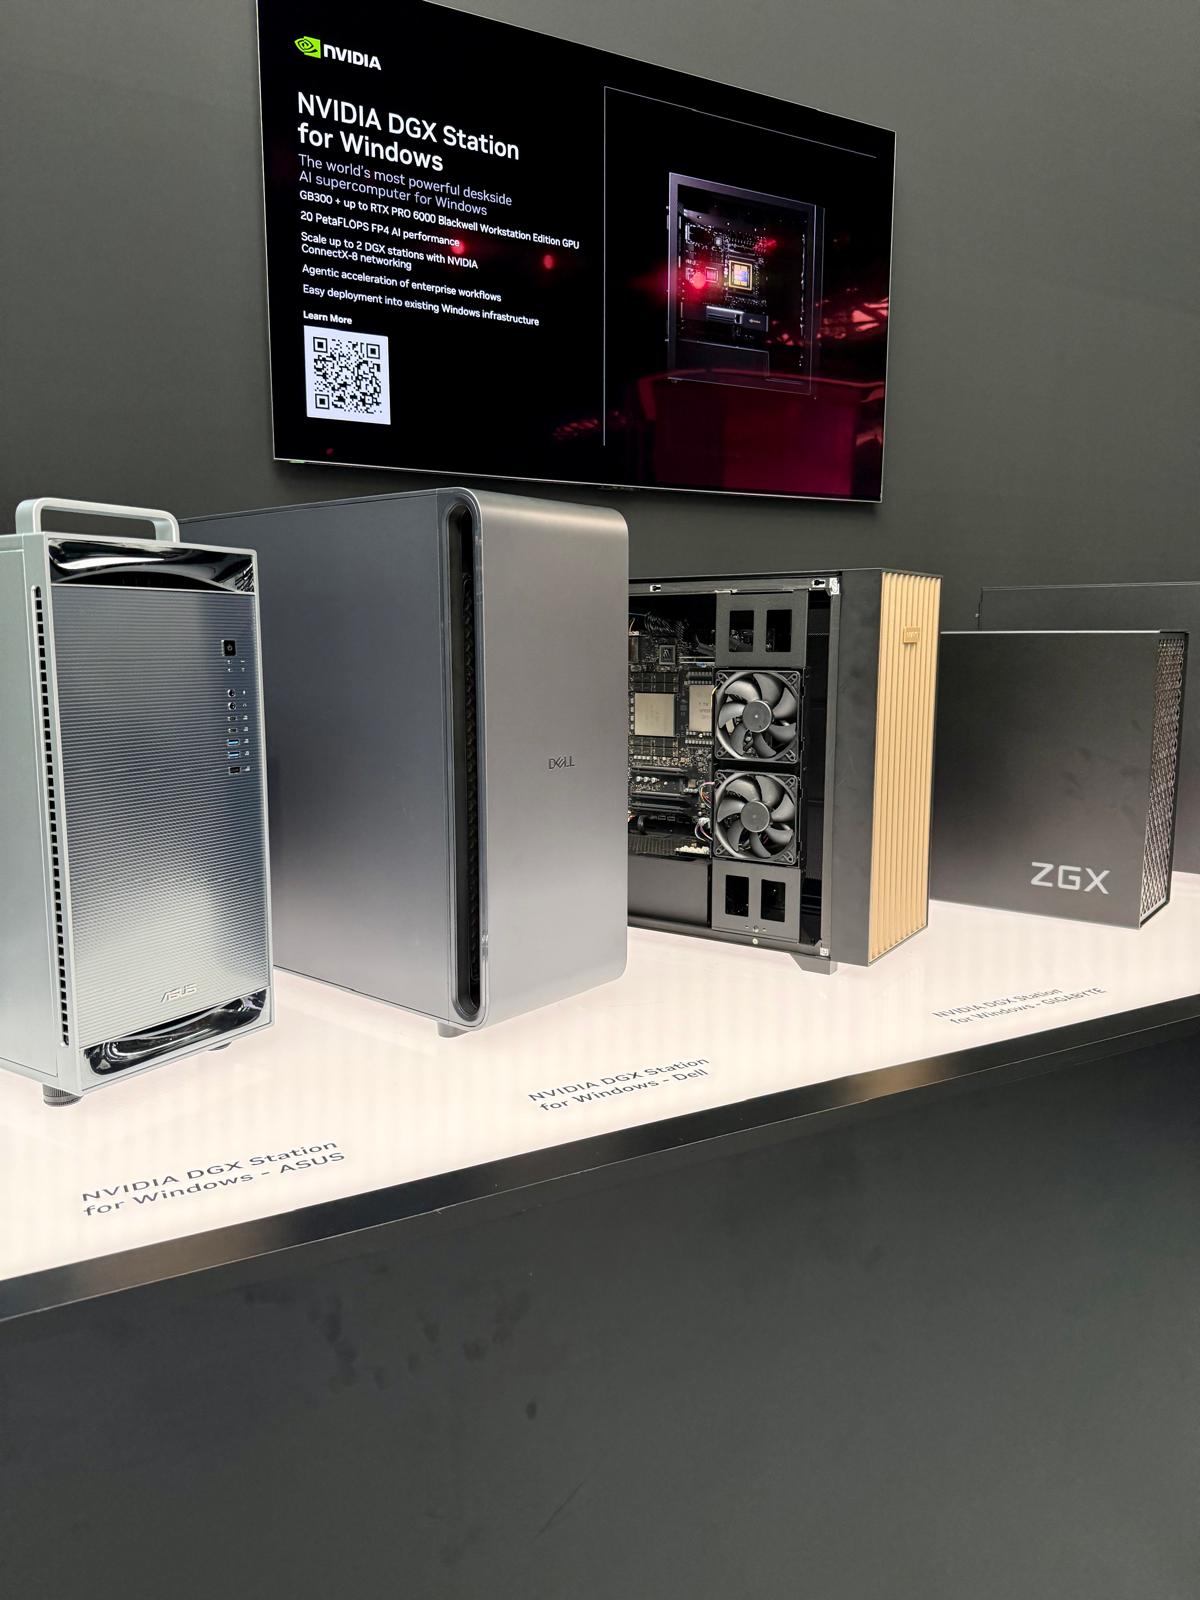 DGX Station für Windows von drei Anbietern. NVIDIA kündigte die Verfügbarkeit für Dezember an.
In einem Labor mit einer einzigen DGX Station kehrt die Lochkarten-Warteschlange meines Vaters zurück: Forscher planen Token-Budgets und buchen Zeitfenster an der leisen Box am Ende des Flurs.
Wen das interessieren sollte
Pay-per-Token verliert seinen Sinn, wenn die Arbeit nie aufhört oder die Daten das Gebäude nicht verlassen dürfen. Dies sind die Anwendungsfälle, die ich mir zuerst ansehen würde, und jeder einzelne war in Berlin vertreten:
- Kontinuierliche Signalströme. Ein Sicherheitsteam aus Agenten und Subagenten, das die Infrastruktur rund um die Uhr überwacht. Direkt neben der OpenShell-Demo zeigte eine Telekom-Demo die 6G-Abdeckungsplanung: eine Always-on-Analyse, die bei einer API Unmengen an Token verbrauchen würde.
- Sensible Daten. Gesundheitsdienstleister und industrielle Engineering-Teams wie Siemens zeigten Fälle, in denen es nicht verhandelbar ist, Daten strikt on-premises zu halten.
- Hardware-in-the-Loop und digitale Zwillinge. Roboter testen, Routen planen, Netzwerke simulieren. Das Beispiel in der Keynote war eine kleine Roboterente. Sie wurde in einem digitalen Zwilling auf einem RTX Spark simuliert, in der Cloud trainiert und zurück auf dem RTX Spark evaluiert, bevor die Policy in den echten Roboter übertragen wurde.
- Bild-, Video- und Audiogenerierung. Medienarbeit ist rechenintensiv und repetitiv. Sogar die Website in der Demo bezog ihre Bilder von einem lokal laufenden Modell.
Die hybride Architektur
Lokale Rechenleistung ergänzt die Cloud-Infrastruktur, anstatt sie zu ersetzen. Die Architektur, die praktisch sinnvoll ist, sieht eine klare Arbeitsteilung vor: Schnelle lokale Modelle bewältigen hohen Durchsatz, während in der Cloud gehostete Frontier-Modelle die übergeordnete Orchestrierung und Validierung übernehmen. Das Video der Roboter-Demo in der Keynote teilte die Arbeit anders auf: Der Sprecher sagte: „Ich lasse alles auf meinem RTX Spark laufen, außer wenn ich größere Workloads in die Cloud auslagern muss“, und dieses Auslagern betraf das Training.
Token waren das Thema der Pre-Keynote-Sessions, wo ein Satz die Stimmung zusammenfasste: „Im Zeitalter der KI sind Intelligenz-Token die neue Währung.“ Ein hybrides Setup hält diese Ausgaben vorhersehbar und im Rahmen des Budgets, während Frontier-Modelle verfügbar bleiben, wenn die Arbeit sie erfordert. Die richtige Arbeit an das richtige Modell auf der richtigen Infrastruktur zu leiten, ist der neue Budgetierungsakt. Er erinnert mich an die Jahre, in denen Daten- und Analyseteams entscheiden mussten, was on-premises und was in der Cloud lief. Ein anderer Sprecher in denselben Sessions beschrieb den Wandel, der mir am wichtigsten ist: „Anstatt nur ein Token-Konsument zu sein, können Sie in dieser Token-Ökonomie auch ein Token-Produzent sein... Das gibt Ihnen Handlungsspielraum. Es gibt Ihnen die Wahl.“
Was meine Meinung geändert hat und was nicht
Was sich geändert hat: Zwei Deskside-Boxen, die ein Team von dreißig Personen unterstützen, haben mir gezeigt, dass für ein kleines Team oder ein Labor der Besitz der eigenen Inferenz nun eine echte Option ohne Serverraum ist.
Was sich nicht geändert hat: Teure Hardware zahlt sich nur aus, wenn sie ausgelastet ist, und lokale Modelle haben immer noch Schwierigkeiten mit langem, mehrstufigem logischem Denken. Das sind die Fragen, die man vor dem Kauf beantworten muss.
Das Petaflop, das laut Jensen 2016 noch von zwei Personen nach oben getragen werden musste, passt heute in einen Rucksack. Ich wette, dass diese Hardware immer kleiner und erschwinglicher wird und in Paketen verkauft wird, die für ein zehnköpfiges Team sinnvoll sind – aber das ist eine Vorhersage, und die Zeit wird es zeigen.
Wie man dreißig Agenten auf diesen zwei Boxen sicher und koordiniert hält, ist das Thema des nächsten Beitrags.
Verfasst von


Contact