


Blog
Testbarkeit und Zuverlässigkeit in agentenbasierten Systemen

Agentenbasierte Systeme entwickeln sich über dialogorientierte und einfache Wissensagenten hinaus hin zu operativen Arbeitsabläufen. Sie können Entscheidungen unterstützen, Aufgaben koordinieren, Anfragen bearbeiten, Aktionen auslösen oder mit Unternehmenssystemen interagieren. Da sich die Einführung dieser Systeme beschleunigt und sie Teil geschäftskritischer Arbeitsabläufe werden, reicht eine flüssige Konversationsfähigkeit nicht mehr aus. Ein System kann überzeugend klingen und dennoch die falsche Entscheidung treffen, die falsche Maßnahme ergreifen oder sich in ähnlichen Situationen inkonsistent verhalten. Bei agentenbasierten Systemen lässt sich Zuverlässigkeit selten allein durch die Eingabe von Befehlen gewährleisten. Die eigentliche Frage ist, ob das System rund um den Agenten testbar, beobachtbar und widerstandsfähig ist, wenn etwas schiefgeht. Zwar ist Beobachtbarkeit an sich wichtig, doch konzentriert sich dieser Beitrag speziell auf Testbarkeit und Zuverlässigkeit, die gemeinsam erörtert werden sollten. Beide hängen davon ab, wie das System konzipiert ist: wie Aufgaben aufgeteilt werden, wie Ergebnisse validiert werden, wo Menschen in den Prozess eingebunden bleiben und wie Fehler eingedämmt werden.
Testbare Architektur
Ein Agent, der eine weit gefasste Anweisungsaufforderung erhält und Zugriff auf zahlreiche Werkzeuge hat, ist von Natur aus schwer zu testen. Wenn das Ergebnis falsch ist, lässt sich nur schwer feststellen, ob der Fehler auf mangelhafte Planung, eine unzureichende Aufforderung, den falschen Einsatz von Werkzeugen, verborgene Annahmen oder einen unbeabsichtigten Nebeneffekt zurückzuführen ist.
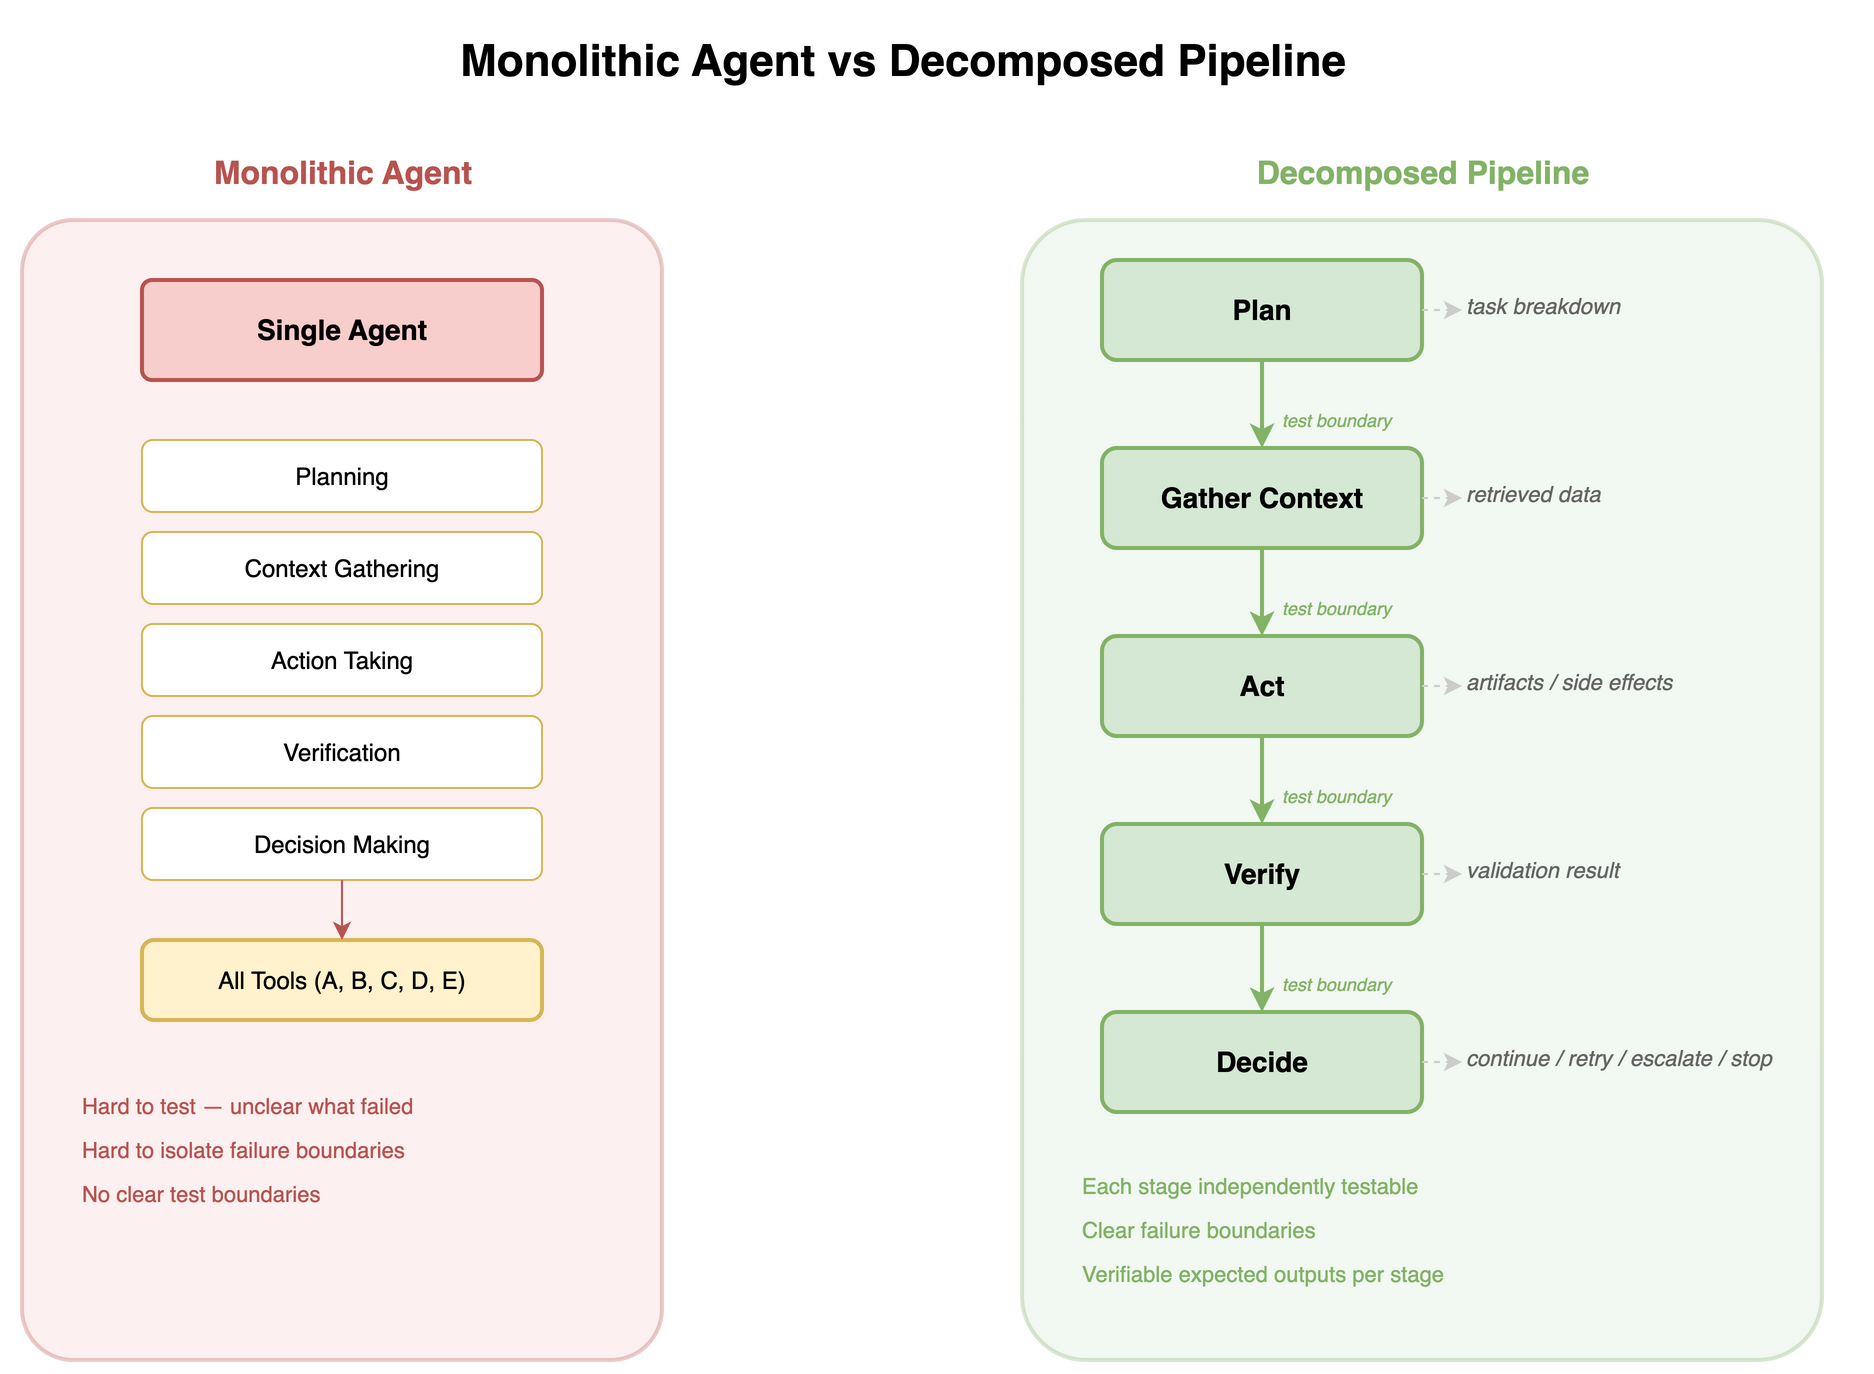
Ein besser testbares Design unterteilt das System in kleinere Komponenten oder Teilagenten mit klar definierten Zuständigkeiten und Ausgabewerten. Zum Beispiel:
- Ein-Komponenten-Pläne
- Man sammelt oder ermittelt den Kontext
- Man ergreift Maßnahmen
- Man überprüft das Ergebnis
- man entscheidet, ob man fortfährt, es erneut versucht, die Angelegenheit eskaliert oder abbricht
Diese Aufgliederung führt zu zwei Ergebnissen: Fehlergrenzen und Testgrenzen. Wenn jede Phase einen klaren Zweck hat, lässt sich leichter feststellen, wo etwas schiefgelaufen ist. Und wenn von jeder Phase erwartet wird, dass sie ein bestimmtes Ergebnis liefert, lässt sich leichter überprüfen, ob sie tatsächlich erfolgreich war.
Das Prinzip ist einfach: Eine Phase ist nicht abgeschlossen, nur weil der Akteur dies behauptet. Sie ist erst dann abgeschlossen, wenn sie das erwartete Ergebnis in einer Form erbracht hat, die die Plattform überprüfen kann.
Zuverlässigkeit durch wiederholten Erfolg
Herkömmliche Softwaretests stellen oft eine binäre Frage: Hat der Code bestanden oder ist er durchgefallen? Das funktioniert bei deterministischen Systemen, reicht jedoch für agentenbasierte Systeme nicht aus. Ein Agent kann eine Aufgabe in einem Durchlauf erfolgreich abschließen, in einigen Durchläufen jedoch scheitern, wenn dasselbe Szenario 10 oder 100 Mal wiederholt wird. Ein solches System ist im betrieblichen Sinne nicht zuverlässig.
Aus diesem Grund sollte die Zuverlässigkeit von Agenten in der Regel über mehrere Durchläufe hinweg gemessen werden. Sinnvollere Fragen sind:
- Wie oft führt das System die Aufgabe erfolgreich aus?
- Wie stabil ist sein Verhalten bei wiederholten Versuchen und realistischen Kontextabweichungen?
- Welche Fehlerarten treten am häufigsten auf und inwieweit lassen sie sich beheben?
- Welche Erfolgsschwelle ist für diese Art von Aufgabe akzeptabel?
Dadurch verlagert sich die Bewertung weg von der Frage „Hat es den Test bestanden?“ hin zur Bewertung der Zuverlässigkeit. Diese Verlagerung ist umso wichtiger bei Arbeitsabläufen, die mehrere Agenten, komplexe Schlussfolgerungen und Interaktionen zwischen verschiedenen Tools beinhalten.
In der Praxis bedeutet dies, dass dasselbe Szenario mehrfach durchgespielt wird, die Erfolgsquote gemessen wird und entschieden wird, ob das Ergebnis für das angestrebte Autonomie-Niveau gut genug ist. Beispielsweise weist ein Szenario, das 17 von 20 Durchläufen besteht, eine Erfolgsquote von 85 % auf. Das mag für einen Assistenten ausreichend sein, der einen Vorschlag zur Überprüfung durch einen Menschen entwirft, nicht jedoch für einen, der Änderungen unbeaufsichtigt umsetzt und dabei ein Ziel von 95 % anstrebt.
Es ist zudem hilfreich, genau zu definieren, was unter „Erfolg“ zu verstehen ist. pass@k (Chen et al., 2021) prüft, ob der Agent bei mindestens einem von k Versuchen erfolgreich ist, was sich für Arbeitsabläufe eignet, bei denen ein erneuter Versuch oder eine manuelle Entscheidung mit geringem Aufwand verbunden ist. „pass^k (τ-bench)“ prüft, ob der Agent bei allen k Versuchen erfolgreich ist; dies ist die aussagekräftigere Messgröße, wenn bei jedem Durchlauf reale Systeme angesprochen werden. Die beiden Werte können sich für denselben Agenten erheblich unterscheiden.
Überprüfen Sie die Ergebnisse, nicht nur die Dialoge
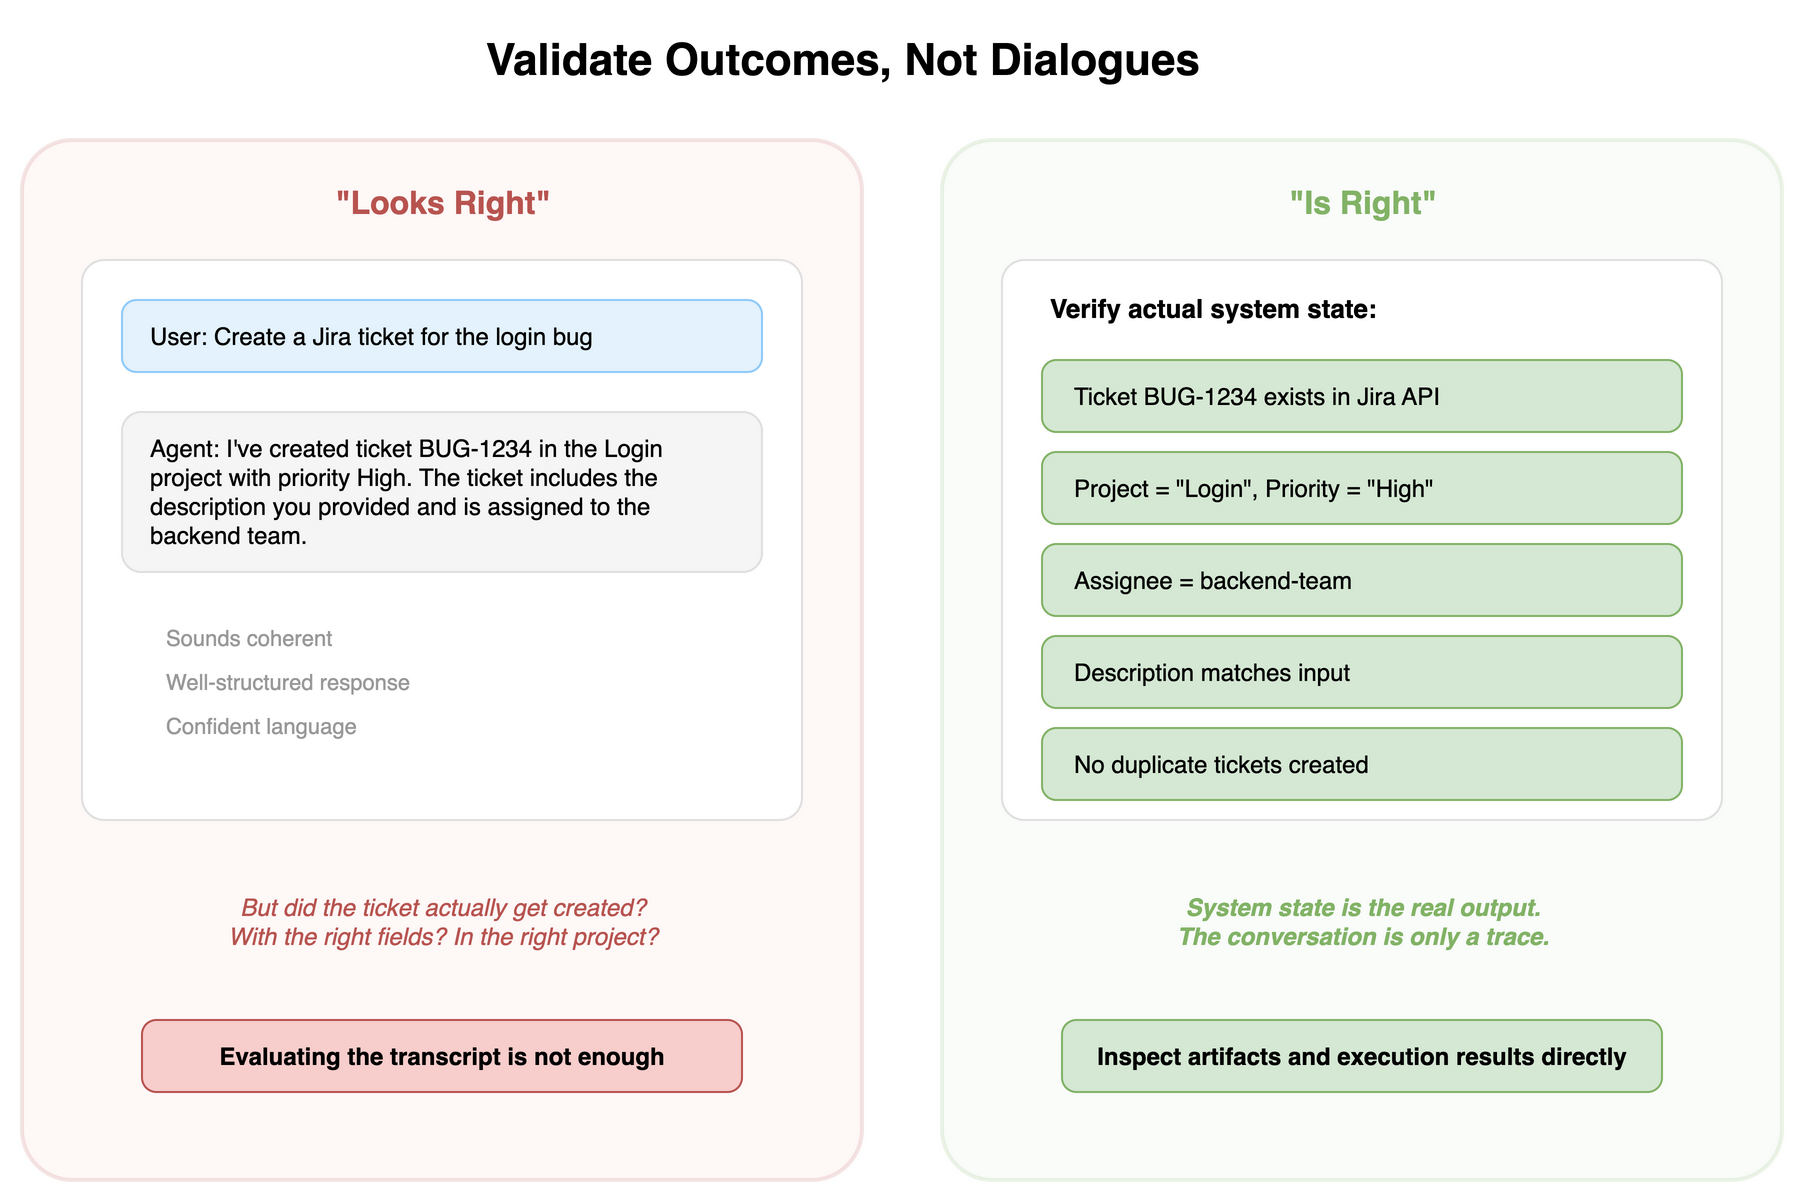
Eine der leichtesten Fallstricke bei der Bewertung von Agenten besteht darin, sich zu sehr auf das Transkript zu konzentrieren. Eine Antwort kann kohärent, bedacht und gut strukturiert wirken, während die eigentliche Arbeit unvollständig oder falsch ist.
Bei handlungsorientierten Systemen sollte der Schwerpunkt der Prüfung auf den Nebenwirkungen liegen:
- Hat das System das erwartete Ergebnis, die erwartete Änderung oder die erwartete Entscheidung hervorgebracht?
- Hat es auf die richtige Ressource, den richtigen Datensatz oder die richtige Umgebung gewirkt?
- Hat die Aktion das beabsichtigte Ergebnis erzielt?
- Wurden unbeabsichtigte Änderungen außerhalb seines Geltungsbereichs vermieden?
Dies ist von Bedeutung, da der Systemzustand das eigentliche Ergebnis darstellt. Der Dialog ist lediglich eine Spur davon, wie versucht wurde, dieses Ergebnis zu erzielen.
Gutes Testen überprüft daher Artefakte und Ausführungsergebnisse direkt. Es überprüft die tatsächlichen Ergebnisse des Systems: geänderte Datensätze, erstellte Tickets, aktualisierte Dokumente, ausgelöste Ereignisse, generierten Code oder nachgelagerte Zustandsübergänge. Es begnügt sich nicht mit der Feststellung: „Die Erklärung klang plausibel.“
Dies führt zudem zu einem ausgereifteren Ansatz bei der Validierung. Nicht alles muss Byte für Byte übereinstimmen. Bestimmte Ausgaben sollten streng geprüft werden, wie beispielsweise erforderliche Schemafelder oder sicherheitskritische Parameter. Andere Ausgaben erfordern möglicherweise strukturelle oder semantische Prüfungen, die harmlose Abweichungen zulassen. Die Zuverlässigkeit verbessert sich, wenn die Validierung dort streng ist, wo es auf die Bedeutung ankommt, und flexibel, wo Abweichungen in der Formatierung akzeptabel sind.
Die Ausführung ist die eigentliche Quelle der Wahrheit
Durch die Überprüfung des Systemzustands erfahren Sie, was der Agent geändert hat. Durch die Ausführung seiner Ausgabe können Sie feststellen, ob diese Ausgabe tatsächlich funktioniert. Ein Agent kann eine Antwort liefern, die plausibel erscheint, sich bei der Ausführung jedoch als unhaltbar erweist. Er kann Code entwerfen, der nicht ausgeführt werden kann, einen Workflow mit falschen Parametern auslösen oder eine Empfehlung aussprechen, die bei der Überprüfung anhand des zugrunde liegenden Systemzustands nicht standhält.
Aus diesem Grund sollte die Prüfung agentischer Systeme, soweit möglich, bei der Ausführung enden. Zum Beispiel:
- Wenn das System Code schreibt, führen Sie diesen aus.
- Wenn es über Tools oder APIs eine Aktion ausführt, überprüfen Sie den daraus resultierenden Zustand.
- Wenn es Konfigurations- oder Workflow-Schritte generiert, validieren Sie diese in einer sicheren Umgebung.
- Wenn es eine Aussage über die Welt trifft, überprüfen Sie diese Aussage anhand einer vertrauenswürdigen Quelle.
Die Ausführung schließt die Lücke zwischen „das erscheint vernünftig“ und „das funktioniert tatsächlich“. Mit diesem Schritt lässt sich die funktionale Korrektheit eines agentenbasierten Systems messen.
Überwachte Autonomie als Mittel zur Sicherstellung der Zuverlässigkeit
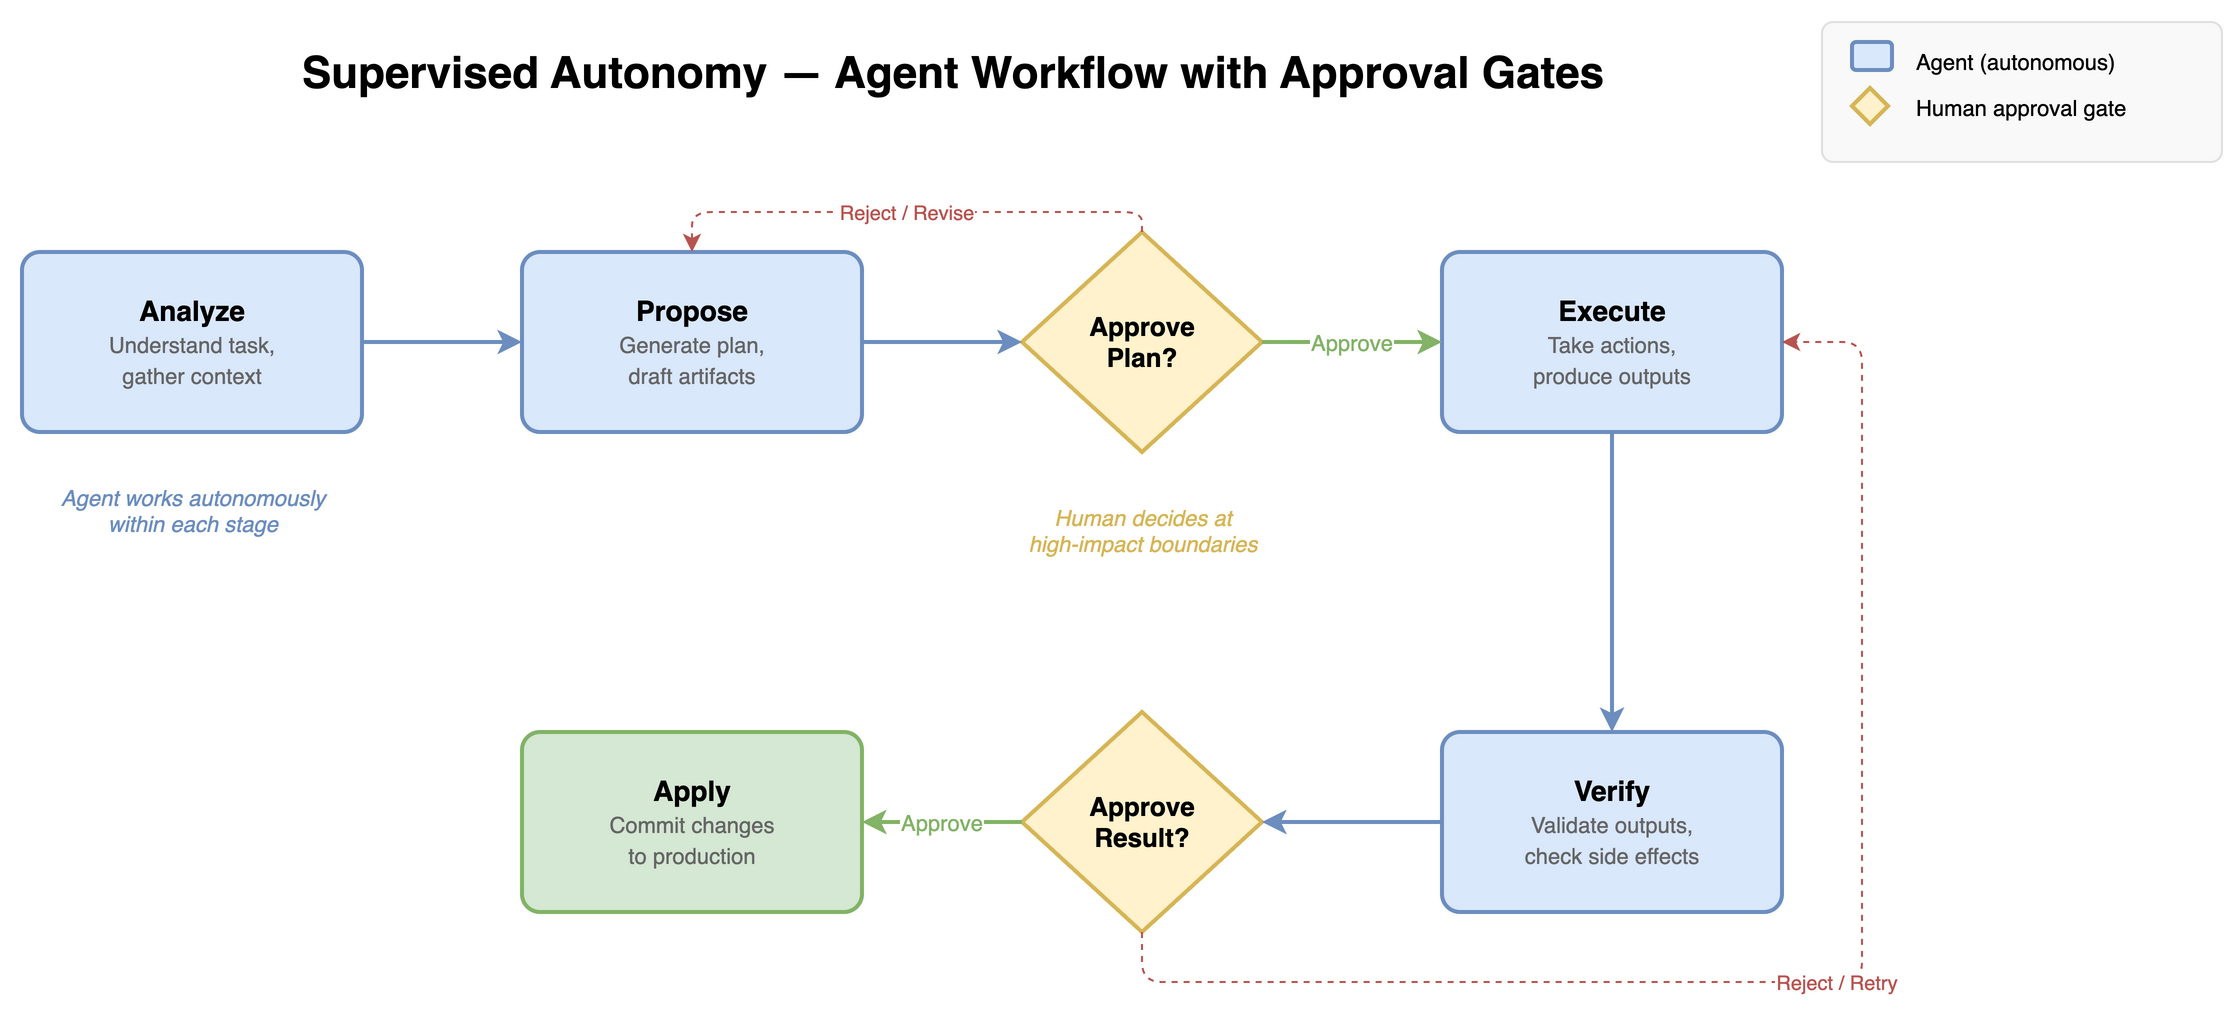
Häufig wird über Autonomie so diskutiert, als bedeute mehr Autonomie automatisch ein besseres System. In der Praxis ist dies jedoch oft das falsche Optimierungsziel. Bei vielen Arbeitsabläufen, insbesondere wenn es sich um semantische oder weitreichende Änderungen handelt, stellt die menschliche Genehmigung keine Schwäche im Design dar. Es handelt sich vielmehr um eine bewusste Zuverlässigkeitskontrolle.
Genehmigungsschritte sind besonders nützlich, wenn das System:
- das Treffen mehrdeutiger Entscheidungen mit geschäftlichen Auswirkungen
- die Wahl zwischen mehreren plausiblen Handlungsoptionen
- Änderungen an produktionsrelevanten Systemen oder für den Benutzer sichtbaren Ergebnissen
- Arbeiten mit unvollständigem Fachkontext
In diesen Fällen ist „überwachte Autonomie“ ein bewährtes Modell: Lassen Sie das System analysieren, Vorschläge unterbreiten, vorbereiten und sogar die endgültigen Ergebnisse entwerfen, verlangen Sie jedoch eine Bestätigung, bevor irreversible oder kostenintensive Änderungen vorgenommen werden. Wenn das System unsicher ist oder ein Durchlauf die Überprüfung wiederholt nicht besteht, sollte es die Angelegenheit an einen Menschen weiterleiten, anstatt den Vorgang unbegrenzt zu wiederholen. Weitere Informationen zur Gestaltung dieser Kontrollpunkte finden Sie unter „Responsible Agentic Workflows for Enterprise AI“.
Dies erhöht die Zuverlässigkeit in zweierlei Hinsicht. Zum einen verringert es die Auswirkungen falscher Entscheidungen, und zum anderen lässt sich der Arbeitsablauf in Tests leichter nachvollziehen, da der erwartete Ablauf explizite Haltepunkte und Entscheidungsgrenzen enthält.
Durch Isolierung lassen sich Fehler eingrenzen und Tests wiederholen
Zuverlässige agentenbasierte Systeme benötigen kontrollierte Ausführungsumgebungen.
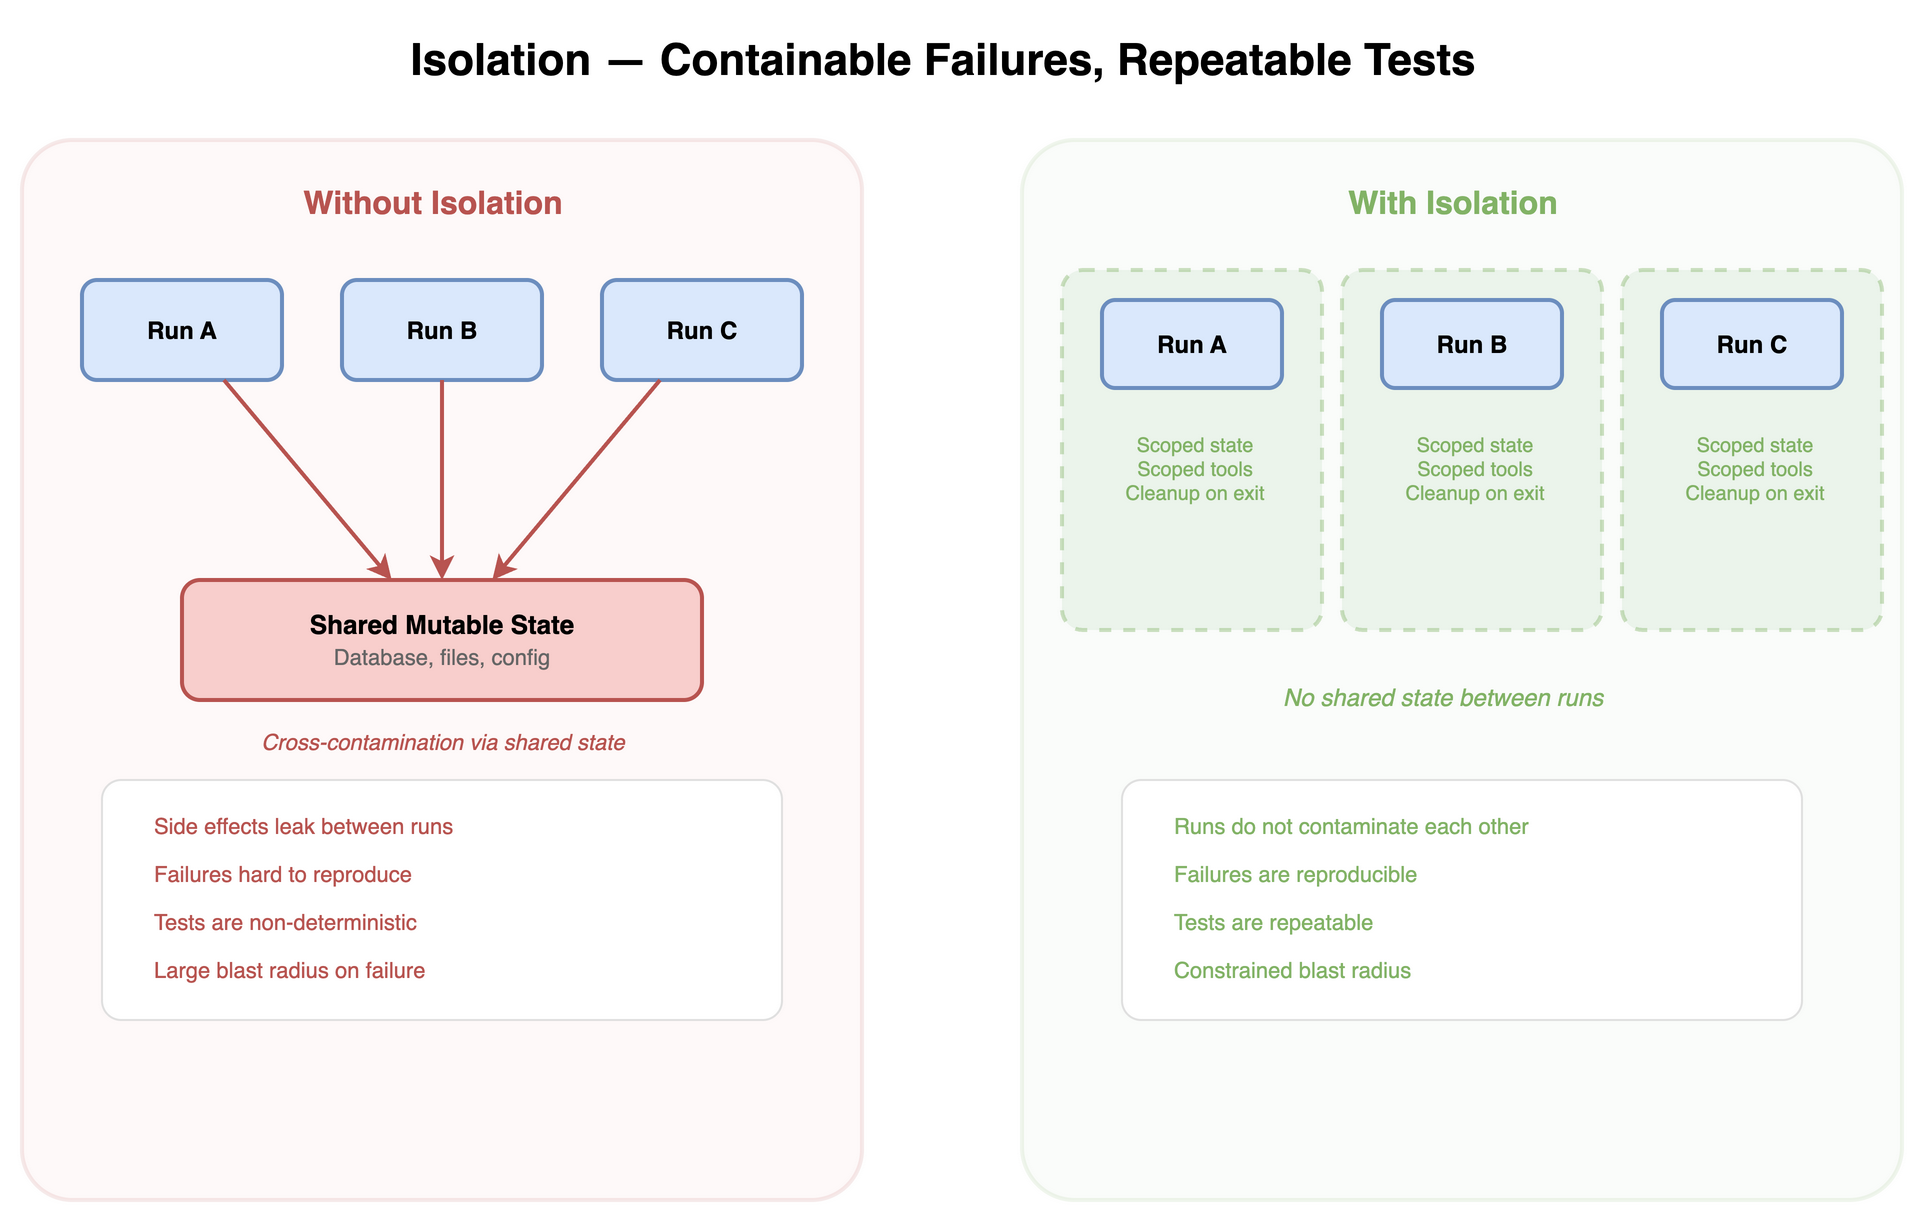
Isolation wird oft als Sicherheitsaspekt diskutiert, ist jedoch für die Testbarkeit ebenso wichtig. Wenn sich mehrere Ausführungsdurchläufe einen veränderbaren Zustand teilen, lassen sich Nebenwirkungen schwerer nachvollziehen und Fehler schwerer reproduzieren.
Isolation kann verschiedene Formen annehmen:
- isolierte Ausführungskontexte
- bereichsbezogene Berechtigungen und Ressourcen
- temporärer oder reversibler Arbeitszustand
- begrenzter Zugriff auf Werkzeuge
- Mechanismen zur Bereinigung und Rücknahme
Dies bietet zwei konkrete Vorteile. Tests lassen sich besser wiederholen, da sich die einzelnen Durchläufe nicht gegenseitig beeinträchtigen. Und das Betriebsrisiko lässt sich leichter bewältigen, da ein ausgefallener oder fehlerhaft funktionierender Agent auf einen kleineren Wirkungsbereich beschränkt ist.
Für Systeme, die Code schreiben, Daten ändern oder die Infrastruktur modifizieren können, ist Isolation keine optionale technische Vorsichtsmaßnahme. Sie ist Teil des Zuverlässigkeitsmodells.
Die Prinzipien in die Praxis umsetzen
Diese Prinzipien lassen sich leichter verstehen, wenn sie in einer konkreten Umsetzung verankert sind. In einem Projekt, bei dem es um agentengestützte ELT-Workflows ging, zeigten sie sich auf praktische Weise:
- Der Arbeitsablauf wurde in kleinere Schritte unterteilt, anstatt aus einem einzigen monolithischen Agenten zu bestehen
- Von jeder Phase wurde erwartet, dass sie bestimmte Artefakte zurückgibt
- Die generierten Dateien wurden validiert und nicht nur beschrieben
- Die Laufzeitausführung diente der Überprüfung der Korrektheit
- Die Benutzer wurden gebeten, semantische Entscheidungen zu genehmigen, bevor endgültige Änderungen übernommen wurden
- Die Durchläufe wurden durch sitzungsgebundene Ressourcen isoliert
Das Projekt selbst ist weniger wichtig als das Muster, das es veranschaulicht. Die Zuverlässigkeit ergab sich nicht aus einer besonders überzeugenden Vorgabe, sondern aus den technischen Einschränkungen des Modells. Falls Ihre Agenten dbt-Code generieren, zeigt der Artikel „Guardrails for AI-written dbt projects“, wie dasselbe Prinzip mithilfe automatisierter Prüfungen umgesetzt wird.
Fazit
Der sinnvollste Ansatz, um über zuverlässige agentenbasierte Systeme nachzudenken, lautet nicht: „Wie mache ich das Modell intelligenter?“, sondern: „Wie mache ich das System überprüfbar?“
Sobald Agenten in realen Systemen agieren können, hängt die Zuverlässigkeit von mehr als nur der Modellqualität ab. Sie hängt von architektonischen Grenzen, der Bewertung wiederholter Durchläufe, der Validierung der Ergebnisse, ausführungsbasierten Prüfungen, menschlicher Freigabe, wo erforderlich, und isolierten Laufumgebungen ab.
Das ist der entscheidende Wandel. Agentenbasierte Systeme wirken nicht mehr wie Demos, wenn sie so aufgebaut sind, dass ihr Verhalten getestet, eingeschränkt und als vertrauenswürdig eingestuft werden kann.
Verfasst von


Contact