


Blog
Managed Apache Flink: So treffen Sie die richtige Wahl zwischen Confluent Cloud und Ververica Cloud
Kafka und Apache Flink haben sich zu einem Standard-Stack für die Stream-Verarbeitung mit geringer Latenz entwickelt. Gemeinsam unterstützen sie Datenteams dabei, Ereignisse in Echtzeit zu verarbeiten, Streaming-Pipelines aufzubauen und operative Anwendungsfälle zu unterstützen, bei denen eine Batch-Verarbeitung nicht in Frage kommt.
Wie sollten Teams bei der Entscheidung zwischen Confluent Cloud und Ververica Cloud für Managed Apache Flink vorgehen?
Teams sollten sich für die Confluent Cloud entscheiden, wenn sie eine integrierte Kafka- und Flink-Plattform mit verwaltetem Kafka, Schema Registry, Konnektoren, Governance und minimalem Einrichtungsaufwand wünschen. Die Ververica Cloud ist die bessere Wahl, wenn Teams eine größere Flexibilität bei der Flink-API, benutzerdefinierte Anwendungen, mehrsprachige Pipelines oder erweiterte zustandsbehaftete Stream-Verarbeitung benötigen.
Der Einsatz von Kafka und Flink in der Produktion erfordert Fachwissen in den Bereichen Optimierung, Überwachbarkeit, Upgrades, Störungsbehebung, Skalierung und Kostenkontrolle. Aus diesem Grund ziehen viele Unternehmen Managed-Plattformen in Betracht. Das Ziel besteht nicht nur darin, den Aufwand für die Infrastruktur zu reduzieren, sondern auch den Datenteams mehr Zeit für den Aufbau zuverlässiger Geschäftspipelines zu verschaffen.
In diesem Artikel vergleichen wir Confluent Cloud und Ververica Cloud als Managed-Apache-Flink-Lösungen. Beide Plattformen unterstützen die Echtzeit-Stream-Verarbeitung, basieren jedoch auf unterschiedlichen Konzepten. Confluent Cloud ist „Kafka-first“, wobei Flink Teil einer umfassenderen Daten-Streaming-Plattform ist. Ververica Cloud ist „Flink-first“ und konzentriert sich auf das gesamte Flink-Entwicklungs- und Laufzeit-Erlebnis.
Warum entscheiden sich Teams für verwaltete Apache-Flink-Plattformen?
Ein selbstverwalteter Kafka- und Flink-Stack bietet den Entwicklerteams ein hohes Maß an Kontrolle, doch diese Kontrolle geht mit betrieblicher Verantwortung einher. Die Teams müssen Cluster bereitstellen, Jobs optimieren, Upgrades verwalten, Ausfälle überwachen, Sicherheitsmaßnahmen konfigurieren und auf Vorfälle reagieren.
Verwaltete Apache-Flink-Plattformen verändern das Betriebsmodell. Anstatt den Großteil ihrer Zeit mit der Wartung der Infrastruktur zu verbringen, können sich die Teams auf die Entwicklung von Streaming-Anwendungen, die Verbesserung der Datenqualität und die Bereitstellung von Echtzeit-Datenprodukten konzentrieren. Managed Services mögen auf der Ebene der Stückpreise teurer erscheinen, doch die Gesamtbetriebskosten ändern sich oft, sobald der Zeitaufwand für die Plattformentwicklung, die Störungsbehebung und die Wartung einbezogen wird.
Die entscheidende Frage ist nicht, ob „Managed Flink“ nützlich ist. Die wichtigere Frage ist, welche „Managed Flink“-Plattform zu Ihrer Architektur, den Kompetenzen Ihres Teams und Ihren Workload-Mustern passt.
Was bietet die Confluent Cloud im Bereich des verwalteten Apache Flink?
Confluent Cloud ist eine verwaltete Daten-Streaming-Plattform, die auf Apache Kafka basiert. Sie vereint verwaltetes Kafka, Schema Registry, Kafka Connect, Governance-Funktionen, Stream-Lineage und verwaltetes Apache Flink in einem einzigen Ökosystem.
Dieser „Kafka-first“-Ansatz ist der wesentliche Vorteil. Kafka-Topics und -Schemas werden als gleichwertige Plattformobjekte behandelt, was die Confluent Cloud für Teams attraktiv macht, die Kafka bereits als Rückgrat ihrer ereignisgesteuerten Architektur nutzen. Flink lässt sich eng mit Kafka-Themen verknüpfen, und die Plattform reduziert den Aufwand für die manuelle Integration zwischen Streaming, Schemaverwaltung, Governance und Konnektoren.
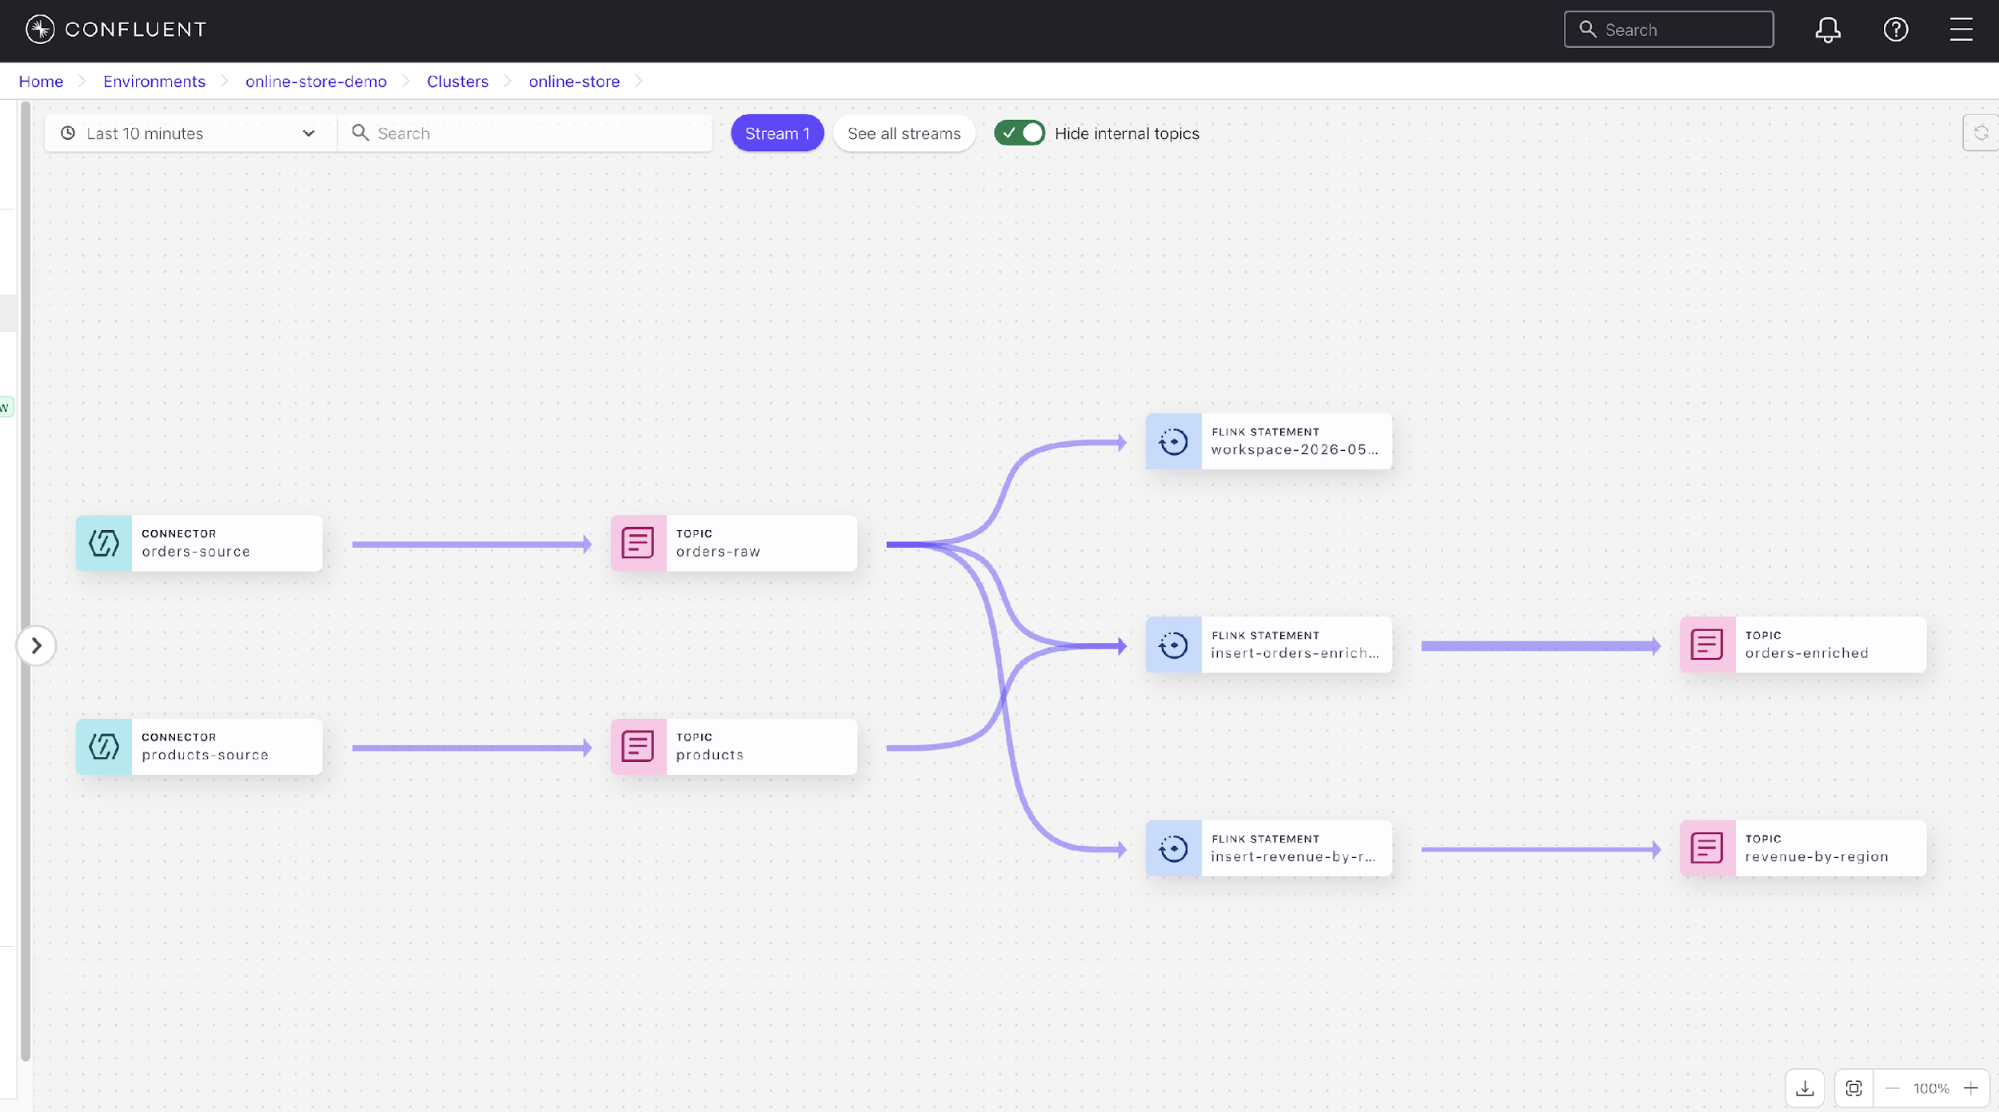
Abbildung 1. Ansicht der Datenflusskette in Confluent Cloud mit Konnektoren, Kafka-Themen und Flink-Anweisungen.
Confluent Cloud eignet sich besonders gut für Teams, die Flink-Workloads erstellen möchten, ohne eine separate Kafka-Infrastruktur verwalten zu müssen. Die Lösung bietet einen browserbasierten SQL-Arbeitsbereich, eine REST-API, die Confluent-CLI sowie Terraform-Unterstützung für „Infrastructure-as-Code“-Workflows. Die Rechenpools skalieren automatisch, sodass Teams Flink-Cluster für typische Workloads nicht manuell dimensionieren und betreiben müssen.
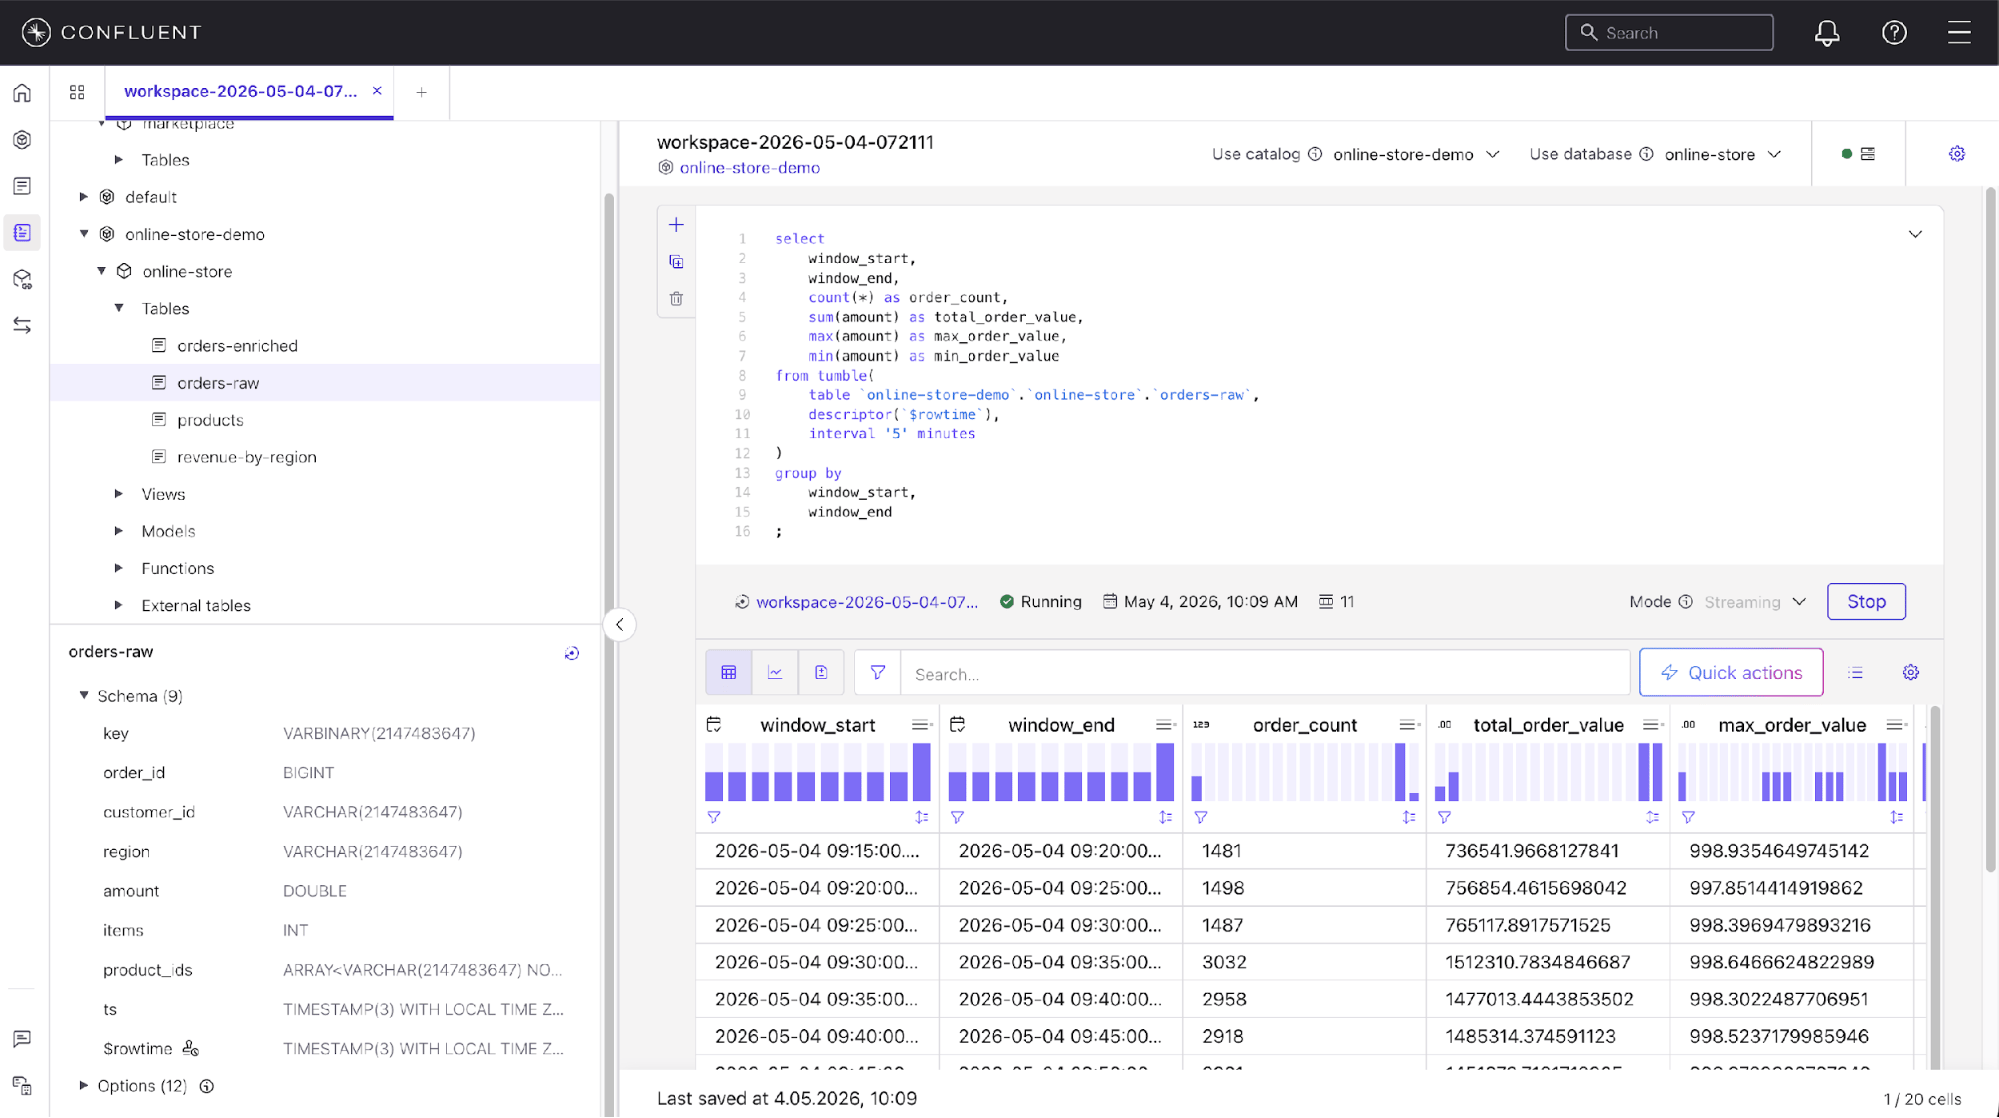
Abbildung 2. Confluent Cloud SQL-Arbeitsbereich für die Entwicklung von Flink-Abfragen und die Überprüfung der Ergebnisse.
Wo lässt sich die Confluent Cloud am besten einsetzen und welche Vor- und Nachteile sind damit verbunden?
Confluent Cloud eignet sich am besten, wenn Teams verwaltete Kafka- und verwaltete Flink-Dienste auf einer einzigen Plattform nutzen möchten und wenn die Anforderungen an die Stream-Verarbeitung hauptsächlich durch Flink SQL oder eine Entwicklung im Stil der Table API ausgedrückt werden können. Dadurch eignet sich die Lösung hervorragend für Datenanreicherung, Filterung, Verknüpfungen, Aggregationen, materialisierte Ansichten und Echtzeit-Pipelines, die nicht die volle Flexibilität der DataStream-API auf Low-Level-Ebene erfordern.
Der wichtigste Kompromiss betrifft die Flexibilität der API. Confluent Cloud ist auf SQL- und Table-API-Workflows optimiert, wobei die Table-API-Unterstützung für Java und Python derzeit in der Dokumentation als Vorschaufunktion ausgewiesen ist. Für Teams, die eine benutzerdefinierte Zustandsverwaltung, fortgeschrittene Ereigniszeitlogik, hochspezialisierte Operatoren oder die vollständige Kontrolle über die DataStream-API benötigen, kann dies einschränkend sein.
Zudem sind Grenzen bei der Arbeitslast zu berücksichtigen. Sehr große zustandsbehaftete Jobs können an Grenzen hinsichtlich der Zustandsgröße oder der Rechenleistung stoßen und eignen sich unter Umständen besser für ein dediziertes Plattformteam oder eine stärker Flink-native verwaltete Umgebung. Confluent Cloud kann dennoch eine gute Wahl sein, doch sollten Teams große zustandsbehaftete Workloads zunächst überprüfen, bevor sie sich für die Plattform entscheiden.
Was bietet Ververica Cloud im Bereich Managed Apache Flink an?
Ververica Cloud verfolgt einen „Flink-first“-Ansatz. Ververica wurde von den ursprünglichen Entwicklern von Apache Flink gegründet, und die Plattform ist auf Stream-Verarbeitung ausgerichtet und nicht auf Kafka als zentrales Produkt.
Das wichtigste Unterscheidungsmerkmal ist die Breite des API-Angebots. Ververica eignet sich besser für Teams, die sowohl mit Flink SQL als auch mit Java-basierten DataStream-Anwendungen und Python-basierter Flink-Entwicklung arbeiten möchten. Diese Flexibilität ist von Bedeutung, wenn Teams maßgeschneiderte Streaming-Anwendungen entwickeln und nicht nur SQL-basierte Transformationen durchführen.
Ververica bietet zudem VERA an, seine Flink-Laufzeitumgebung für Unternehmen. VERA umfasst proprietäre Erweiterungen auf Basis von Apache Flink, darunter Gemini für umfangreiche zustandsbehaftete Workloads, erweiterte CDC-Funktionen, Dynamic Complex Event Processing sowie weitere Laufzeitverbesserungen, die speziell für betrieblich anspruchsvolle Streaming-Anwendungen entwickelt wurden.
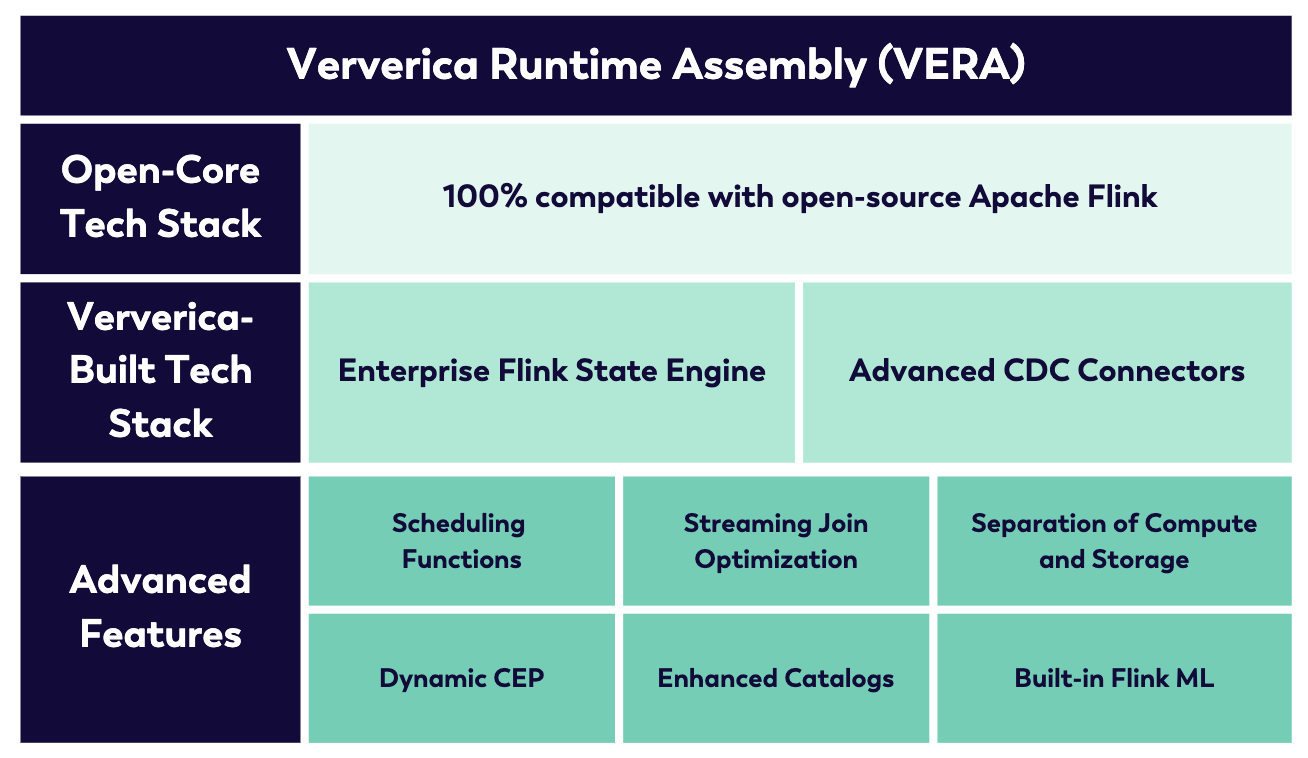
Abbildung 3. Überblick über die Ververica Runtime Assembly (VERA).
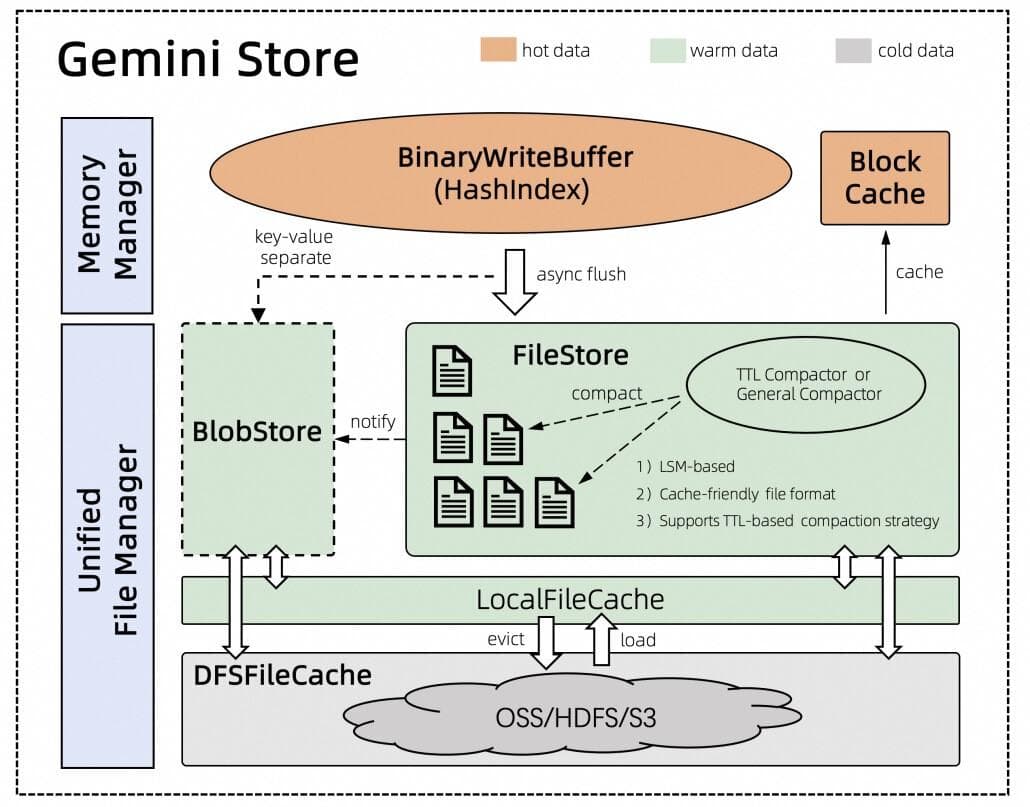
Abbildung 4. Architektur des Gemini-State-Backends. Bildquelle: Alibaba Cloud-Blog.
Da Ververica auf Flink basiert, ist es besonders attraktiv für Teams mit fundierten Flink-Kenntnissen, komplexen Anforderungen an die zustandsbehaftete Verarbeitung oder Anforderungen, die über die Standard-SQL-Stream-Verarbeitung hinausgehen.
Wo lässt sich Ververica Cloud am besten einsetzen und welche Vor- und Nachteile gibt es?
Ververica Cloud funktioniert am besten, wenn die Flink-Anwendung selbst im Mittelpunkt der Architektur steht. Sie eignet sich besonders für Teams, die eine maßgeschneiderte Stream-Verarbeitungslogik, komplexe Ereigniszeit-Verarbeitung, mehrsprachige Entwicklung, die Verwaltung umfangreicher Zustände oder fortgeschrittene zustandsbehaftete Verarbeitungsmuster benötigen.
Der wesentliche Kompromiss besteht darin, dass Ververica nicht dasselbe integrierte Kafka-Ökosystem wie Confluent Cloud bietet. Teams müssen ihre eigene Messaging-Infrastruktur bereitstellen und betreiben oder Ververica mit einem externen Kafka-Dienst verbinden. Zudem müssen sie eine externe Schema-Registry oder eine Governance-Ebene integrieren, sofern diese Funktionen erforderlich sind.
Dies bedeutet, dass Ververica mehr Flexibilität für Flink-zentrierte Workloads bieten kann, jedoch möglicherweise mehr architektonische Entscheidungen in Bezug auf Nachrichtenübermittlung, Schemata, Katalogisierung und Governance erfordert. Für manche Teams ist dies ein Vorteil. Für andere bedeutet dies zusätzlichen Integrationsaufwand.
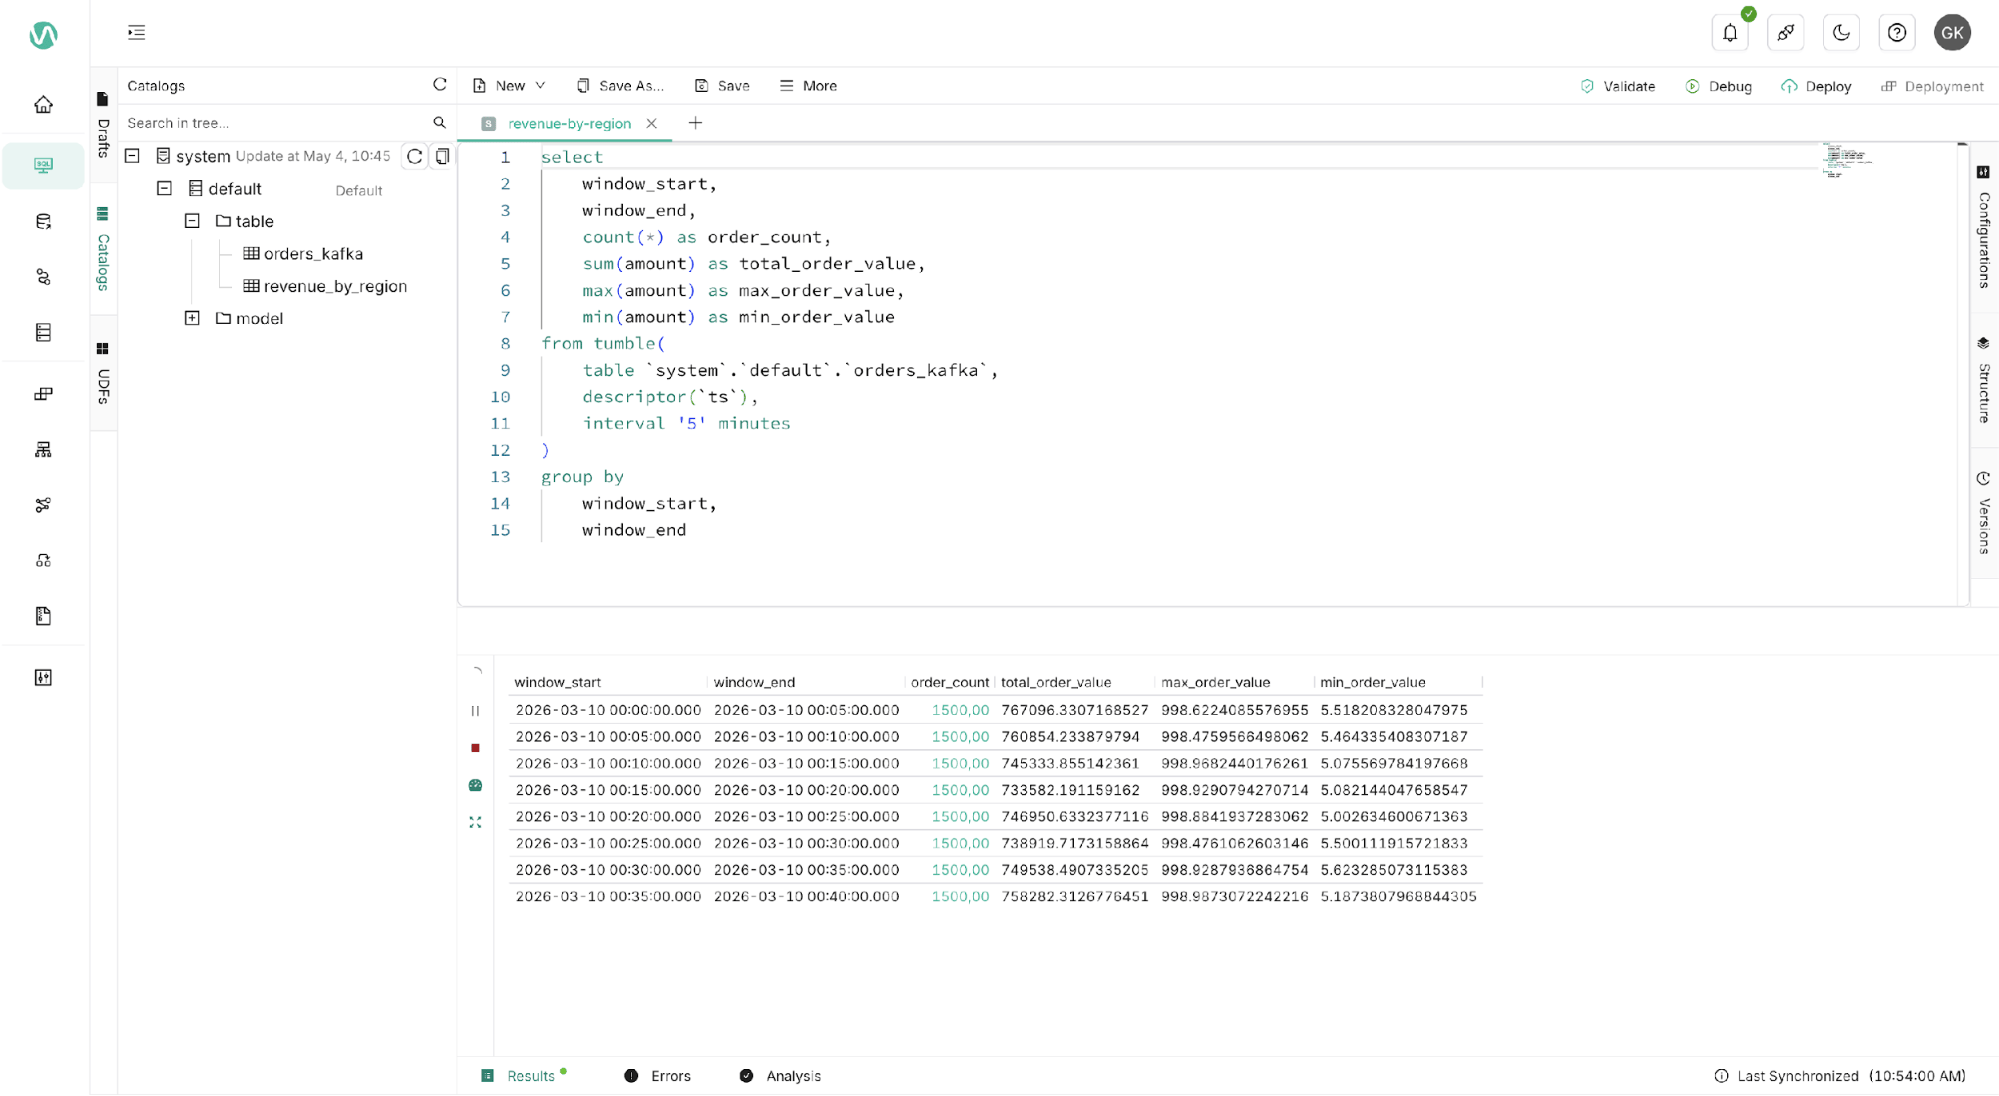
Abbildung 5. Ververica-SQL-Editor mit Katalogansicht und Abfrageergebnissen.
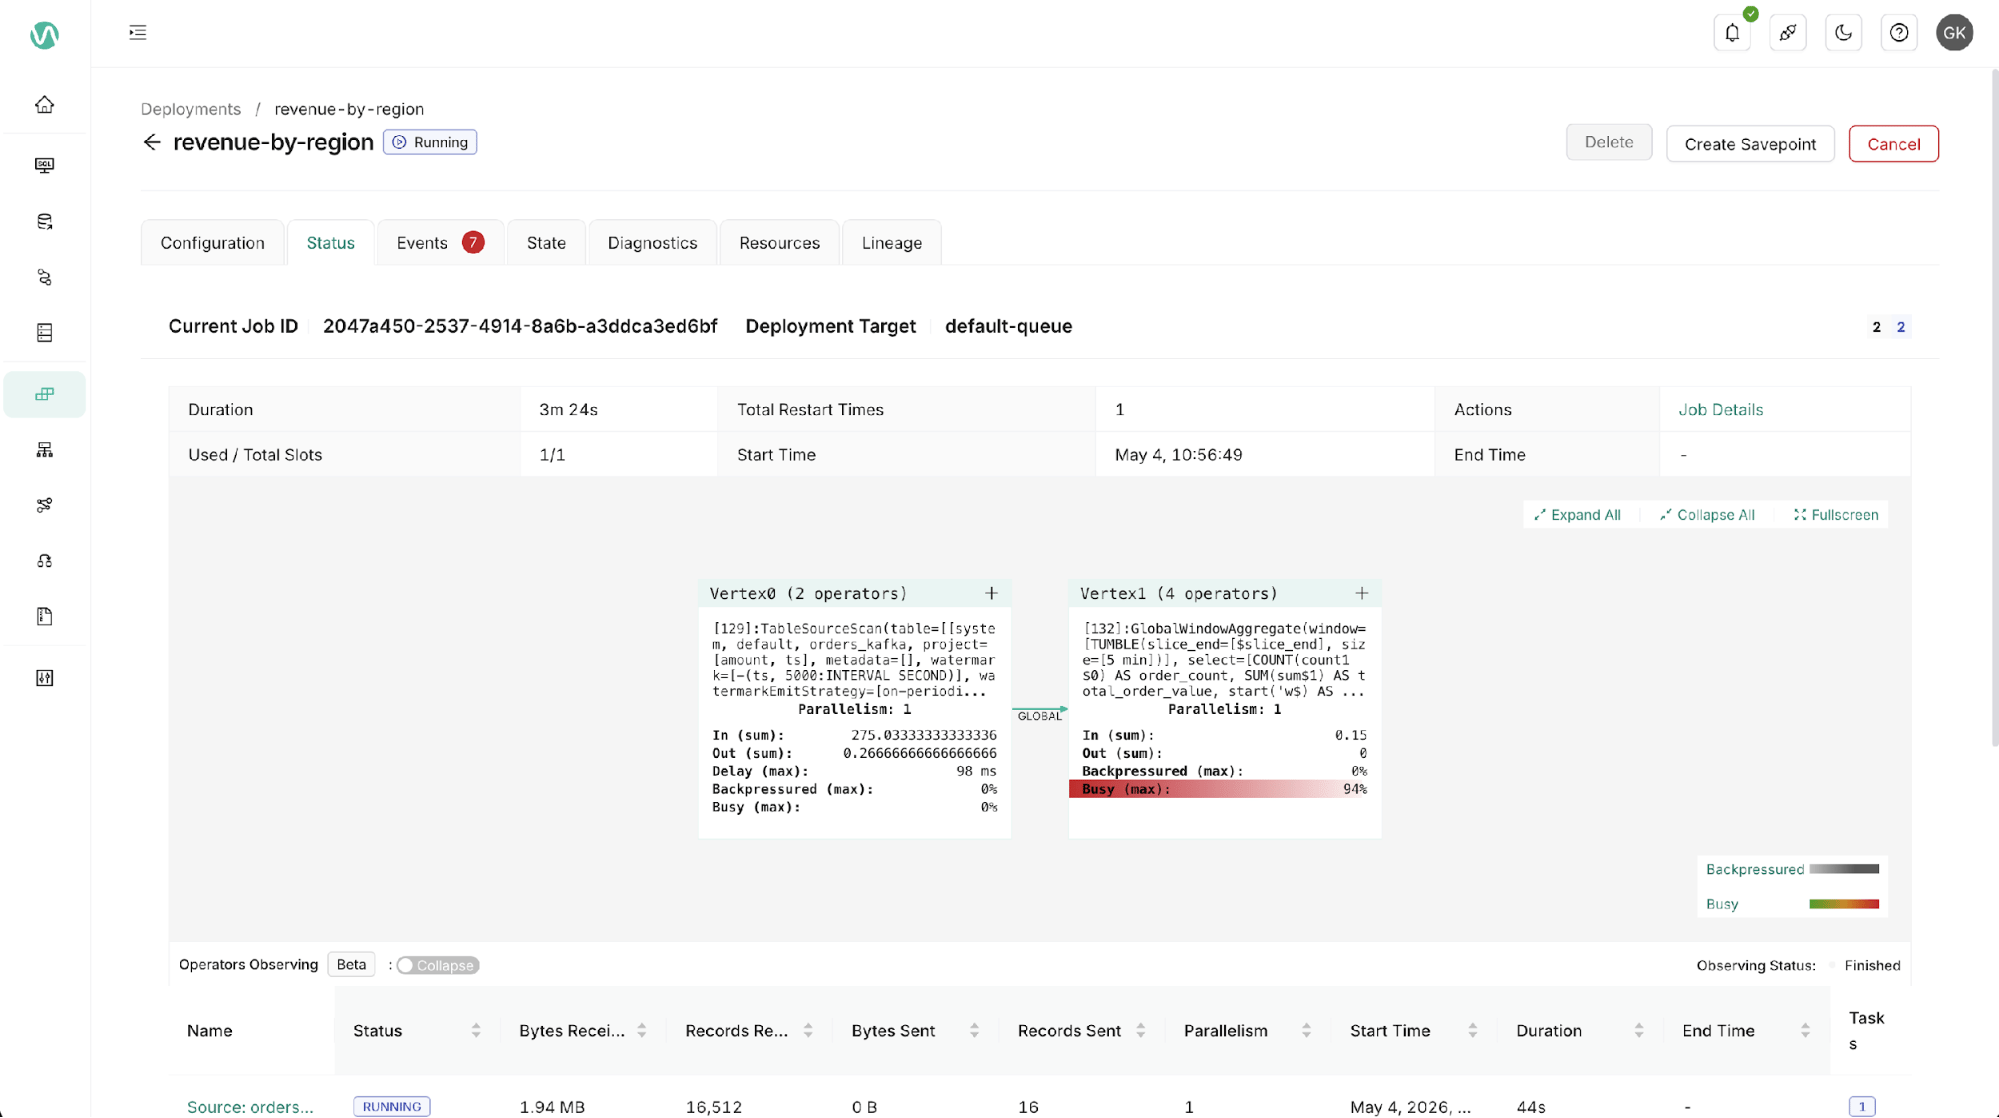
Abbildung 6. Ansicht des Ververica-Bereitstellungsstatus mit Metriken für den Laufzeitbetreiber.
Wie lassen sich Confluent Cloud und Ververica Cloud miteinander vergleichen?
Die Wahl der richtigen Plattform hängt davon ab, worauf Ihr Team den Schwerpunkt legen möchte: Integration, Flexibilität, einfache Bedienung, zustandsbehaftete Verarbeitung oder bereits getätigte Investitionen in Kafka. In der folgenden Tabelle sind die wichtigsten Unterschiede zusammengefasst.
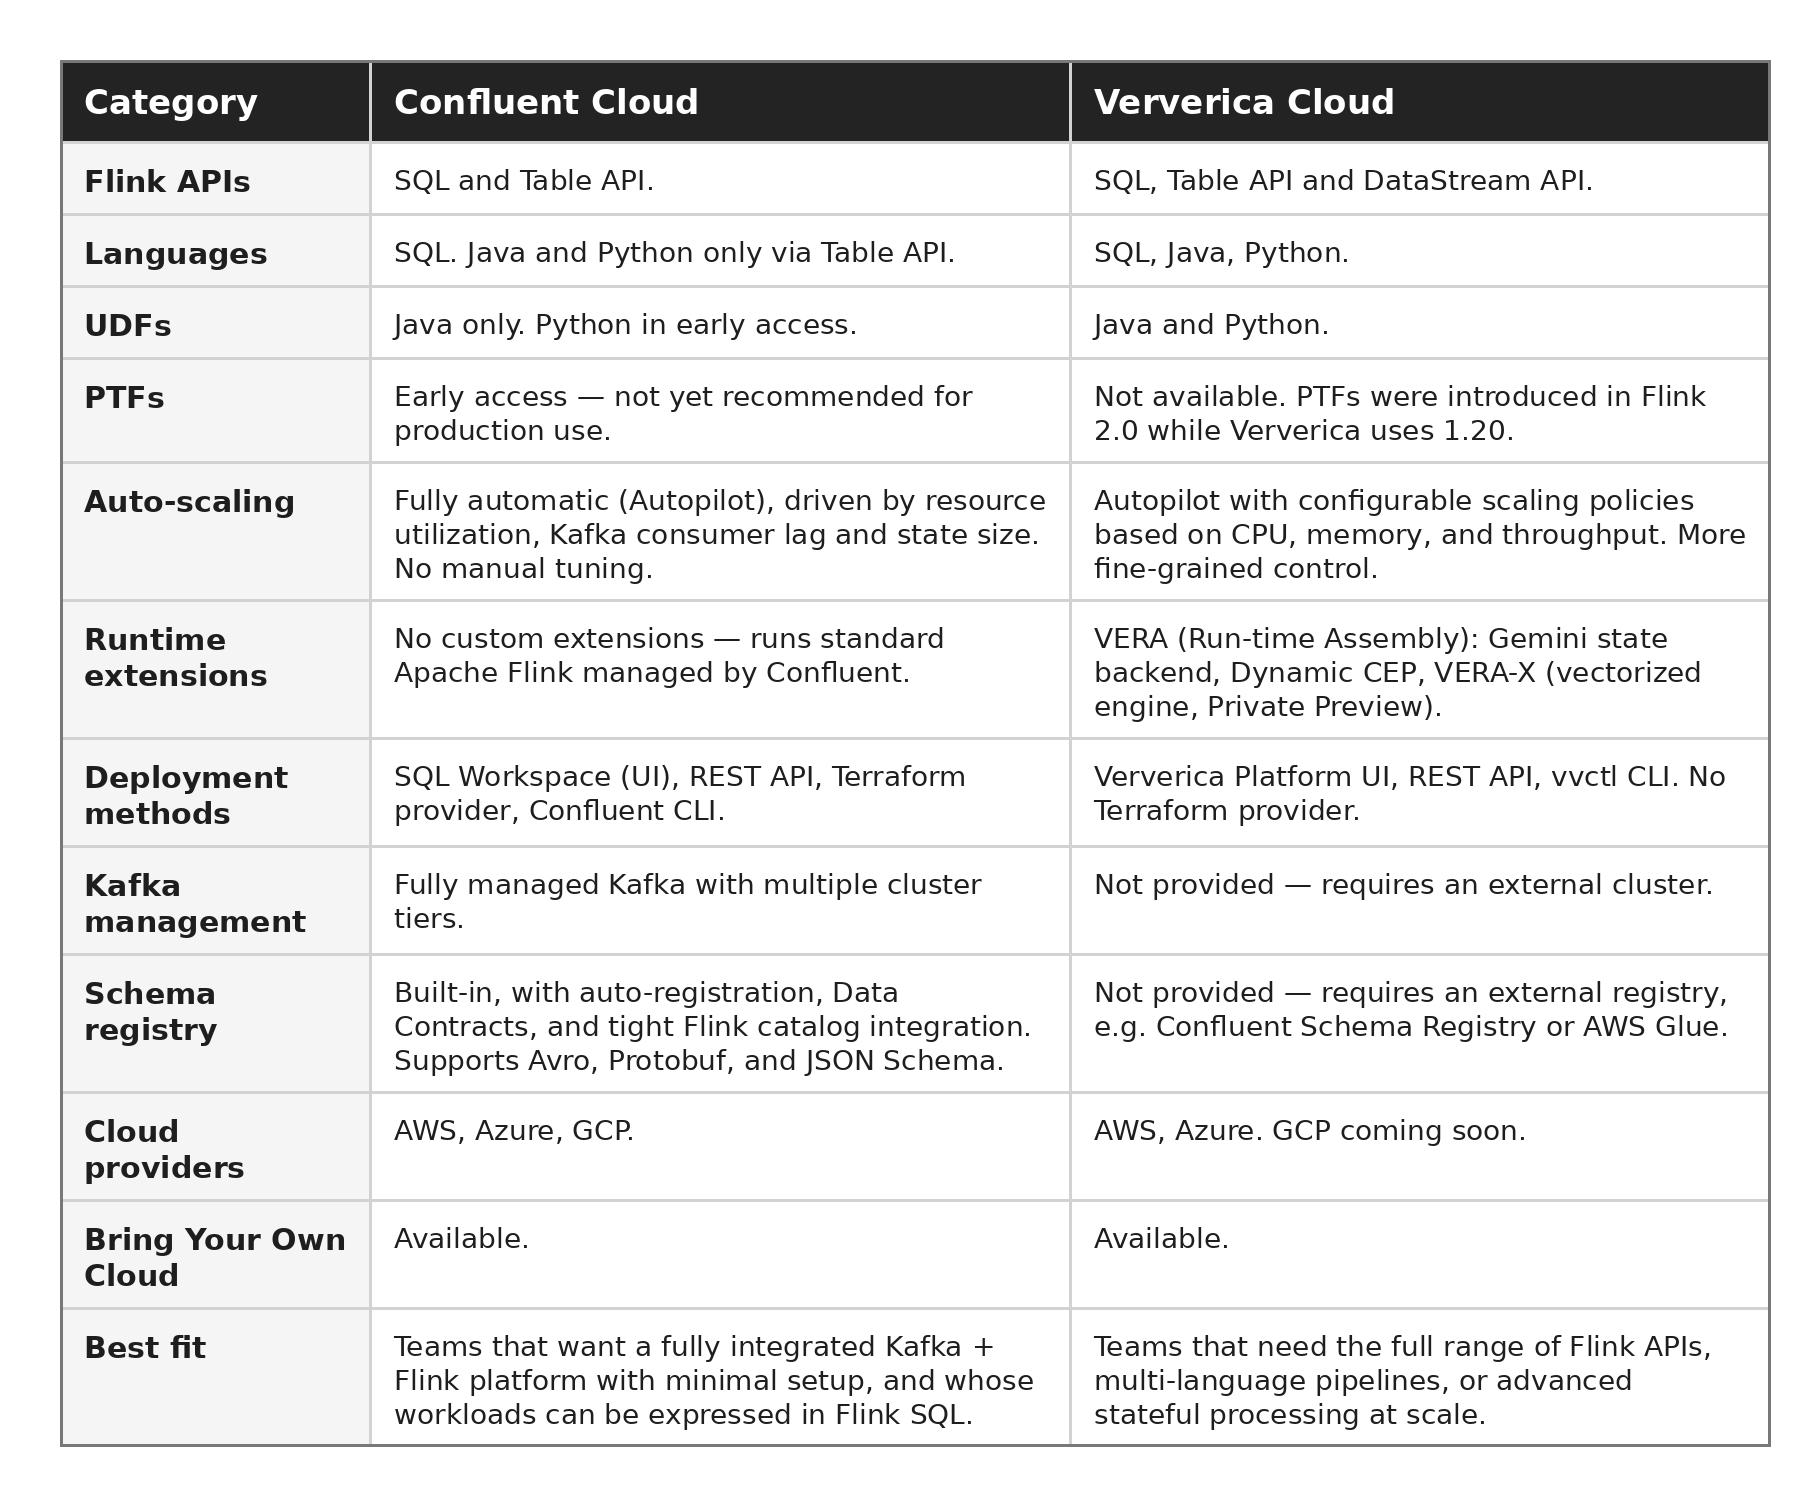
Wie sollten Teams sich zwischen Confluent Cloud und Ververica Cloud entscheiden?
Entscheiden Sie sich für Confluent Cloud, wenn Ihr Team eine vollständig verwaltete Kafka- und Flink-Plattform mit einer engen Integration zwischen Themen, Schemata, Konnektoren, Governance und SQL-basierter Stream-Verarbeitung wünscht. Dies ist die naheliegendere Wahl, wenn einfache Bedienbarkeit und die Integration in das Ökosystem wichtiger sind als die Kontrolle über Flink auf Low-Level-Ebene.
Entscheiden Sie sich für Ververica Cloud, wenn Ihr Team Flink als erstklassige Entwicklungsplattform benötigt. Dies ist die bessere Wahl, wenn Ihre Workloads maßgeschneiderte Flink-Anwendungen, eine größere API-Flexibilität, erweiterte zustandsbehaftete Verarbeitung oder Flink-spezifische Laufzeitfunktionen erfordern.
Für viele Teams läuft die Entscheidung auf eine Frage hinaus: Entscheiden Sie sich für eine Kafka-basierte Streaming-Plattform, die Flink beinhaltet, oder für eine Flink-basierte Plattform für fortgeschrittene Stream-Verarbeitung?
Zusammenfassend lässt sich sagen:
Sowohl Confluent Cloud als auch Ververica Cloud erleichtern den Einsatz von Apache Flink, lösen jedoch unterschiedliche Probleme. Confluent Cloud spielt seine Stärken besonders dann aus, wenn Teams eine integrierte Kafka- und Flink-Umgebung mit verwaltetem Kafka, Schema Registry, Konnektoren, Governance und SQL-gesteuerten Streaming-Workloads wünschen.
Ververica Cloud spielt ihre Stärken besonders dann aus, wenn Teams eine größere Flexibilität bei Flink, die Entwicklung in mehreren Sprachen, maßgeschneiderte Anwendungen zur Stream-Verarbeitung sowie eine erweiterte zustandsbehaftete Verarbeitung benötigen. Sie bietet Flink-Teams mehr Spielraum bei der Entwicklung komplexer Anwendungen, erfordert jedoch auch mehr Entscheidungen in Bezug auf Kafka, das Schemamanagement und die zugehörige Architektur.
Die beste Wahl hängt von Ihrem Arbeitsaufkommen, den Kompetenzen Ihres Teams und Ihrer Plattformstrategie ab. Wenn integrierte Kafka-Abläufe für Sie im Vordergrund stehen, ist Confluent Cloud oft die bessere Wahl. Wenn Sie Wert auf den vollen Funktionsumfang von Flink und eine fortschrittliche zustandsbehaftete Verarbeitung legen, ist Ververica Cloud wahrscheinlich die bessere Option.
Häufig gestellte Fragen
Verfasst von


Contact