Ich habe kürzlich an einem Anwendungsfall zur Bedarfsprognose für einen Kunden aus der Energiebranche gearbeitet. Eines der Hauptziele des Projekts bestand darin, die Machbarkeit und die erwartete Leistungsfähigkeit des Prognosemodells im Vergleich zu historischen Daten zu bewerten. Mein Kollege Max van den Hoven hat die wichtigsten Erkenntnisse aus diesem Projekt in diesem Beitrag zusammengefasst, dessen Lektüre ich empfehle.
Für diese Bewertung haben wir eine Backtesting-Pipeline entwickelt, die die Frage beantwortet, wie gut sich Ihr Modell im Produktivbetrieb bewähren wird. Ein Backtest simuliert dazu die Vergangenheit. Das Modell wird anhand der bis zu einem bestimmten Zeitpunkt verfügbaren Daten trainiert, anschließend prognostizieren wir den darauf folgenden Zeitraum und vergleichen diese Prognose mit dem tatsächlichen Verlauf. Die Ergebnisse eines Backtests sind die Grundlage für konkrete Entscheidungen: Welche Merkmale sollen beibehalten, welche Parameter angepasst werden und ob das Modell gut genug ist, um eingesetzt zu werden.
All dies hängt von einer wichtigen Annahme ab: dass der Backtest die Realität widerspiegelt. Ist dies nicht der Fall, führt er uns mit zu optimistischen Ergebnissen in die Irre. Das Modell schneidet im Backtest besser ab, als es in der Praxis jemals sein kann, und die Diskrepanz zeigt sich erst nach einer Weile, wenn das Modell bereits im Einsatz ist.
Es gibt einige Gründe, warum ein Backtest von der Realität abweichen kann. Verteilungsverschiebungen und neue saisonale Effekte sind die bekanntesten. Ein heiklerer Grund ist das zeitliche „Leakage“: Wissen aus der Zukunft fließt in einen Prozess ein, der eigentlich in der Vergangenheit ablaufen soll. Ein Backtest erfordert, dass das Modell in der Vergangenheit angesiedelt ist, der Bewerter jedoch in der Gegenwart. Das Modell darf nur das nutzen, was unmittelbar vor Beginn der Prognose bekannt war, und alles ab dem Prognosefenster dient lediglich dazu, das Modell daran zu messen. Wenn dem Modell irgendwelche dieser späteren Daten zugänglich werden, verschafft es sich einen Vorteil, den es im Produktionsbetrieb niemals haben wird, und die Bewertungskennzahlen verlieren ihre beabsichtigte Aussagekraft.
In diesem Beitrag konzentrieren wir uns auf eine automatisierte Methode zur Erkennung von Datenverlusten in Zeitreihen, die in ein Prognosemodell eingespeist werden – nicht nur als Audit, sondern als Regressionstest, der in Ihrer CI-Pipeline ausgeführt werden kann.
Temporal Data
Aus Sicht der Prognose weist jeder zeitliche Datenpunkt zwei Zeitattribute auf:
- Zeitpunkt des Auftretens: Zu welchem Zeitpunkt der Datenwert auftritt. Z. B. Mittwoch, 3. September 2026, 3 Uhr morgens MEZ.
- Zeitpunkt der Kenntnisnahme: Zu welchem Zeitpunkt war der Wert bekannt?
Auf dieser Grundlage können wir einige Datentypen definieren:
- Realisiert oder vergangen: Daten, bei denen
occurrence_time <= knowledge_time. Die tatsächlichen Werte, die im Nachhinein bekannt sind. Z. B. Wettermessungen. - Vintage oder zu einem bestimmten Zeitpunkt: Daten, bei denen
occurrence_time > knowledge_timegilt. Die heute bekannte Wettervorhersage für die kommenden 3 Tage. - Bekannte Zukunft: Daten, über deren Zukunft wir vollständige und perfekte Kenntnis besitzen. Kann als Vintage mit
knowledge_time == -∞definiert werden.
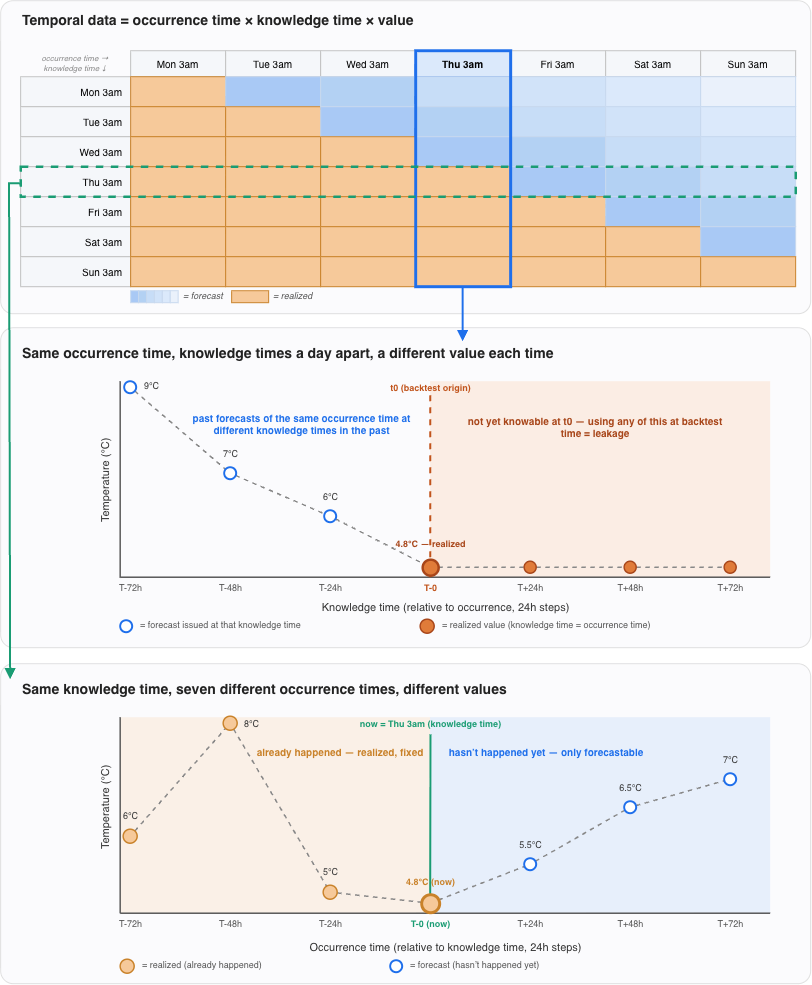 Dieselbe Wetterquelle, dargestellt entlang zweier verschiedener Achsen. Legt man einen Zeitpunkt des Auftretens fest (Mitte), verschiebt sich der Wert mit dem Eintreffen neuerer Vorhersagen so lange, bis er durch den tatsächlichen Messwert endgültig festgelegt wird. Legt man einen Zeitpunkt der Kenntnisnahme fest (unten), erhält man das, was zu diesem Zeitpunkt tatsächlich vorlag: links die tatsächlichen Werte, rechts die Vorhersagen. Einem Modell, das zu
t0 + 1 laufen muss, steht nur die zweite Darstellung zur Verfügung.
Das Trainieren und Ausführen eines Prognosemodells erfordert in der Regel, dass einige oder alle bisherigen Daten so aufbereitet werden, dass sie als Merkmale vom Modell verarbeitet werden können. Beim Backtesting definieren wir einen Trainingszeitraum [training_start, forecast_start) und einen Prognosezeitraum [forecast_start, forecast_end], wobei es von großer Bedeutung ist, dass alle Daten, auf die das Modell (während des Trainings oder Backtestings) Zugriff hat, der Regel knowledge_time < forecast_start entsprechen. Jeder Verstoß gegen diese Regel kann zu einem Informationsleck führen.
„Unter ‚Leakage‘ versteht man jeden Verstoß gegen
knowledge_time < forecast_start.“
Leckageerkennung
Ein Modell, das über den Prognosezeitraum [forecast_start, forecast_end] einem Backtesting unterzogen wird, sollte (zum Zeitpunkt der Inferenz) niemals Daten mit knowledge_time >= forecast_start sehen oder (zum Zeitpunkt des Trainings) gesehen haben. Dies muss durch eine sorgfältige Gestaltung der Backtesting-Pipeline und der Datenmerkmale sowie später durch eine statische Codeanalyse sichergestellt werden. Doch damit kommt man nur bis zu einem gewissen Punkt. Wenn Ihr Anwendungsfall an Komplexität zunimmt, entwickeln sich auch Ihre Merkmale weiter und werden komplexer, verflechten sich miteinander und lassen sich immer schwerer verwalten. Zudem ist es unrealistisch anzunehmen, dass unmittelbar nach jeder Codeänderung eine statische Analyse durchgeführt wird. Wir benötigen einen automatisierten Weg, um das Vorhandensein von zeitlichen Datenlecks in unserer Pipeline zu überprüfen. Im Idealfall möchten wir diesen Prozess genauso ausführen wie unsere Unit-Tests in unserer CI/CD-Umgebung, um sicherzustellen, dass neue Codeänderungen keine Regressionen verursachen.
Ein Modell, das über den Prognosezeitraum [forecast_start, forecast_end] einem Backtesting unterzogen wird, sollte (zum Zeitpunkt der Inferenz) niemals Daten mit knowledge_time >= forecast_start sehen oder (zum Zeitpunkt des Trainings) gesehen haben. Dies muss durch eine sorgfältige Gestaltung der Backtesting-Pipeline und der Datenmerkmale sowie später durch eine statische Codeanalyse sichergestellt werden. Doch damit kommt man nur bis zu einem gewissen Punkt. Wenn Ihr Anwendungsfall an Komplexität zunimmt, entwickeln sich auch Ihre Merkmale weiter und werden komplexer, verflechten sich miteinander und lassen sich immer schwerer verwalten. Zudem ist es unrealistisch anzunehmen, dass unmittelbar nach jeder Codeänderung eine statische Analyse durchgeführt wird. Wir benötigen einen automatisierten Weg, um das Vorhandensein von zeitlichen Datenlecks in unserer Pipeline zu überprüfen. Im Idealfall möchten wir diesen Prozess genauso ausführen wie unsere Unit-Tests in unserer CI/CD-Umgebung, um sicherzustellen, dass neue Codeänderungen keine Regressionen verursachen.
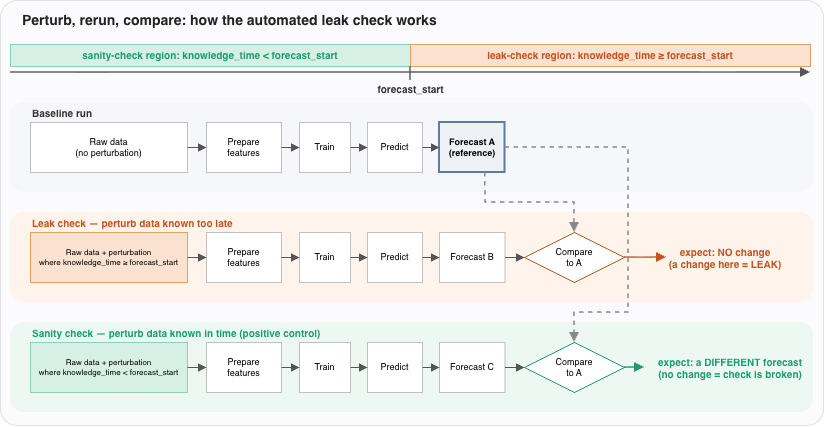 Drei Durchläufe derselben Pipeline. Die Basislinie liefert die Prognose A. Die Leckprüfung verfälscht alles, was das Modell nicht sehen darf, und muss A exakt reproduzieren. Die Plausibilitätsprüfung verfälscht das, was das Modell sehen darf, und darf A nicht reproduzieren: Wenn das Ergebnis unverändert bleibt, hat die Störung das Modell nie erreicht und die obige Leckprüfung hat nichts bewiesen.
Risiken und Hinweise
- Damit dies optimal funktioniert, müssen Sie ein gewisses Maß an Determinismus zwischen den einzelnen Durchläufen der Trainings-Inferenz-Pipeline sicherstellen. Einige Merkmale entsprechen möglicherweise Stichproben, die aus einer probabilistischen Verteilung entnommen wurden, die auf den von Ihnen geänderten Daten basiert. Ist die Stichprobenziehung nicht reproduzierbar, könnten unterschiedliche Durchläufe zu unterschiedlichen Ergebnissen führen, selbst wenn die zugrunde liegenden Daten nicht verändert wurden. Bei den meisten Stichprobenverfahren lässt sich zur Gewährleistung der Reproduzierbarkeit ein Zufallsstartwert festlegen. Achten Sie darauf, diesen zu verwenden.
- Wenn man eine Störung in die Daten einführt, ist es neben der Filterung nach
knowledge_timewichtig, Daten innerhalb des richtigen Ereignisfensters zu berücksichtigen. Eine Möglichkeit besteht darin, den Zeitpunkt des Auftretens zu ignorieren und einfach sicherzustellen, dass alle Daten geändert werden; dies könnte jedoch zu einem Überschwingen führen oder aufgrund der Datenmengen in der Praxis nicht durchführbar sein. Fügen Sie in diesem Fall je nach Fenster zusätzliche Filter füroccurrence_timehinzu und überprüfen Sie, ob der Vorgang ausgeführt wird.
Zeig mir den Code!
Diese Methode zur Lecksuche erfordert eine Änderung der Rohdaten. Es wird empfohlen, die physischen Datenquellen nicht zu verändern, sondern sicherzustellen, dass Ihre Backtesting-Pipeline das Laden der Daten in zwei separate Schritte unterteilt: das Laden der Rohdaten und die Transformation. Die Daten sollten unmittelbar nach dem Laden der Rohdaten und vor der Transformation verändert werden. Dies ermöglicht eine parametrisierte Datenverfälschung, ohne die ursprünglichen Datenquellen zu verändern, und stellt gleichzeitig sicher, dass Datenlecks erkannt werden, die während der Datentransformation auftreten könnten (z. B. undichte Datenaggregationen oder Verknüpfungen).
Die Backtesting-Pipeline
Nehmen wir also einmal an, dass Ihre Backtesting-Pipeline in Python in etwa so aussieht:
# backtest.py
def run_backtest(
    training_start: pd.Timestamp,
    forecast_start: pd.Timestamp,
    forecast_end: pd.Timestamp,
) -> np.ndarray:
    # Load the raw data
    raw_weather = load_raw_weather("data/weather.parquet")
    raw_target = load_raw_target("data/demand.parquet")

    # Prepare the features and the train/forecast split
    features = transform_to_features(raw_weather, raw_target, forecast_start)
    train, forecast_window = split_train_forecast(features, training_start, forecast_start, forecast_end)

    # Initialize the model and train
    model = ForecastingModel()
    model.fit(train[["temperature_feature"]], train["demand"])

    # Predict on the forecast window
    forecast = model.predict(forecast_window[["temperature_feature"]])

    # Compare the forecast to what actually happened
    mae = mean_absolute_error(forecast_window["demand"], forecast)
    logger.info(f"Backtest MAE for [{forecast_start.date()}, {forecast_end.date()}]: {mae:.2f}")
    return forecast
Es gibt zwei Rohdatenquellen: Nachfragedaten und Wetterdaten. Die Nachfrage ist das Ziel und wird ausschließlich mit einer occurrence_time angegeben. Der Datenlader geht davon aus, dass die knowledge_time mit der occurrence_time übereinstimmt:
# mydata.py
def load_raw_target(path: str) -> pd.DataFrame:
    """Raw demand readings. A reading is known the moment it occurs."""
    target = pd.read_parquet(path)  # columns: occurrence_time, demand
    target["knowledge_time"] = target["occurrence_time"]
    return target
Die Wetterdaten enthalten einen occurrence_time- und einen knowledge_time-Wert, was sie zu einer historischen Quelle macht. Der Temperaturwert für eine bestimmte Stunde taucht mehrmals auf und spiegelt die vergangenen Vorhersagen zu verschiedenen Kenntniszeitpunkten wider. Sobald der Kenntniszeitpunkt den Eintrittszeitpunkt erreicht, erhalten wir die tatsächlich gemessenen Temperaturen, die von da an unverändert bleiben.
# mydata.py
def load_raw_weather(path: str) -> pd.DataFrame:
    """Raw weather feed: forecasts and realized measurements side by side."""
    return pd.read_parquet(path)  # columns: occurrence_time, knowledge_time, temperature
Anschließend werden die Daten in Merkmale umgewandelt, wobei die Daten, die das Modell nicht sehen soll, auf der Grundlage des gewünschten Startzeitstempels für die Prognose herausgefiltert werden. Außerdem wird der aktuellste Jahrgang als aktuellste Informationsquelle beibehalten.
# mydata.py
def transform_to_features(
    raw_weather: pd.DataFrame,
    raw_target: pd.DataFrame,
    forecast_start: pd.Timestamp,
) -> pd.DataFrame:
    """Shape the raw sources into a single model-ready feature frame."""
    knowable = raw_weather[raw_weather["knowledge_time"] <= forecast_start]

    # Per occurrence_time, keep only the latest vintage that was already
    # knowable: the freshest forecast available at forecast_start, or the
    # realized measurement once it exists.
    latest_vintage = knowable.sort_values("knowledge_time").groupby("occurrence_time").last()

    features = latest_vintage.rename(columns={"temperature": "temperature_feature"})
    features = features.join(raw_target.set_index("occurrence_time")["demand"], how="left")
    return features.reset_index()
Wenn man sich diese Funktion genauer ansieht, fällt vielleicht schon ein Problem auf, aber lassen Sie uns weitermachen.
Verfälschung der Rohdaten
Nun ist es an der Zeit, unsere Störung in die Daten einzufügen. Die folgende Funktion übernimmt dies. Sie zielt auf eine Teilmenge der Zeilen des geladenen Dataframes ab und multipliziert deren numerische Spalten mit einem großen Faktor.
def perturb(df: pd.DataFrame, mask: pd.Series, factor: float = 10.0, seed: int = 0) -> pd.DataFrame:
    """Scale every numeric value of the masked rows by a random factor."""
    rng = np.random.default_rng(seed)
    perturbed = df.copy()
    for column in df.select_dtypes("number").columns:
        random_factor = rng.uniform(0.5 * factor, 1.5 * factor, size=int(mask.sum()))
        perturbed.loc[mask, column] = df.loc[mask, column] * random_factor
    return perturbed
Beachten Sie, dass der Faktor nicht konstant bleibt, sondern pro Zeile zufällig ermittelt wird. Ein einziger konstanter Multiplikator würde jede Zeile in derselben relativen Reihenfolge belassen. Dies könnte bei Modellen problematisch sein, die nicht skalierungsempfindlich sind (z. B. aufgrund einer Normalisierung), da das Ergebnis eine Änderung der Eingabe nicht widerspiegeln würde. Daher führen wir im Multiplikationsfaktor eine unabhängige Zufälligkeit pro Zeile ein.
Den Loader patchen
Als Nächstes müssen wir unsere Störung genau zwischen dem Einlesen der Rohdaten und der Transformation der Daten einfügen. Für eine einmalige Überprüfung könnten wir den Code der Backtesting-Funktion anpassen. Wenn wir dies jedoch regelmäßig (d. h. in einer CI/CD-Pipeline) als Test nach jedem Commit ausführen möchten, müssen wir den Loader anpassen und die Backtesting-Funktion unverändert lassen.
Dazu können wir die Loader-Funktion per „Monkey Patch“ modifizieren. Auf diese Weise können wir die Rohdaten vor ihrer Umwandlung ändern, ohne den Produktionscode zu verändern.
from pytest import MonkeyPatch


class BacktestWindow(NamedTuple):
    training_start: pd.Timestamp
    forecast_start: pd.Timestamp
    forecast_end: pd.Timestamp


def forecast_with_perturbed_source(
    module: ModuleType,
    loader_name: str,
    hits: Callable[[pd.Series], pd.Series],
    window: BacktestWindow,
) -> np.ndarray:
    """Re-run the backtest with `module.loader_name` corrupted on the rows `hits` selects."""
    original_loader = getattr(module, loader_name)

    def patched_loader(*args, **kwargs):
        raw = original_loader(*args, **kwargs)
        return perturb(raw, hits(raw["knowledge_time"]))

    with MonkeyPatch.context() as patch:
        patch.setattr(module, loader_name, patched_loader)
        return backtest.run_backtest(*window)
Der modifizierte Loader ruft weiterhin den eigentlichen Loader auf, fügt jedoch einen Aufruf der Funktion „perturb“ hinzu, um die Daten zu verändern, bevor sie an die Backtesting-Funktion zurückgegeben werden.
Die beiden Schecks
Nun sind beide Prüfungen derselbe Aufruf mit entgegengesetzten Masken und entgegengesetzten Erwartungen:
def check_source(
    module: ModuleType, loader_name: str, window: BacktestWindow, baseline: np.ndarray
) -> dict:
    """Run the leak check, plus its positive control, on a single raw source."""
    forecast_start = window.forecast_start

    # Corrupt what the model must not see: the forecast must not move.
    leak = forecast_with_perturbed_source(
        module, loader_name, lambda known_at: known_at >= forecast_start, window
    )

    # Corrupt what the model does see: the forecast must move, otherwise the
    # perturbation never reached the model and the check above proved nothing.
    sanity = forecast_with_perturbed_source(
        module, loader_name, lambda known_at: known_at < forecast_start, window
    )

    return {
        "source": f"{module.__name__}.{loader_name}",
        "leak_check_passed": same_forecast(baseline, leak),
        "sanity_check_passed": not same_forecast(baseline, sanity),
    }
Zwei Vorhersagen können sich auch dann geringfügig voneinander unterscheiden, wenn keine Störung einfließt. Das könnte an kleinen Rundungsfehlern liegen. Daher müssen wir sie unter Berücksichtigung einer bestimmten Toleranz vergleichen:
def same_forecast(baseline: np.ndarray, other: np.ndarray, atol: float = 1e-6, rtol: float = 1e-5) -> bool:
    """Compare two forecasts, with a tolerance for rounding noise."""
    return np.allclose(baseline, other, atol=atol, rtol=rtol)
Nun fügen wir alles zusammen, indem wir den Backtest einmal ausführen, um die Basislinie zu ermitteln, und ihn anschließend einmal pro Loader ausführen, den wir auf Datenlecks und korrekte Funktionsweise testen möchten:
import backtest

RAW_LOADERS = [
    (backtest, "load_raw_weather"),
    (backtest, "load_raw_target"),
]

WINDOW = BacktestWindow(
    training_start=pd.Timestamp("2026-01-01"),
    forecast_start=pd.Timestamp("2026-03-01"),
    forecast_end=pd.Timestamp("2026-03-31"),
)

def report(results: list[dict], window: BacktestWindow) -> None:
    print(f"\nLeakage checks for forecast window [{window.forecast_start.date()}, {window.forecast_end.date()}]")
    for result in results:
        leak = "PASS" if result["leak_check_passed"] else "FAIL <- possible leak"
        sanity = "PASS" if result["sanity_check_passed"] else "FAIL <- no effect, check is inconclusive"
        print(f"  [{result['source']}] leak check:   {leak}")
        print(f"  [{result['source']}] sanity check: {sanity}")

def run_leakage_checks(window: BacktestWindow) -> list[dict]:
    """Run the leak check and the sanity check on every raw source."""
    baseline = backtest.run_backtest(*window)
    return [check_source(module, loader_name, window, baseline) for module, loader_name in RAW_LOADERS]


if __name__ == "__main__":
    report(run_leakage_checks(WINDOW), WINDOW)
Dies führt zu fünf Durchläufen der Backtest-Funktion: einem Baseline-Durchlauf und jeweils zwei pro Quelle (ein „Leak“-Durchlauf und ein „Sanity Check“-Durchlauf). Wir führen den Test auf einem bewusst kurzen Trainings- und Prognosefenster durch, um die Ausführungszeit zu verkürzen.
Ausführen
Leakage checks for forecast window [2026-03-01, 2026-03-31]
  [backtest.load_raw_weather] leak check:   FAIL <- possible leak
  [backtest.load_raw_weather] sanity check: PASS
  [backtest.load_raw_target] leak check:   PASS
  [backtest.load_raw_target] sanity check: PASS
Die Zielquelle scheint sicher zu sein. Die Wetterquelle hingegen nicht: Verfälschte Temperaturwerte, die erst ab oder nach forecast_start erkennbar wurden, haben die Vorhersage verändert. Das bedeutet, dass etwas aus dem Vorhersagefenster in das Modell gelangt ist. Kehren Sie nun zur Funktion transform_to_features zurück und versuchen Sie, das Problem zu finden. Haben Sie es entdeckt?
knowable = raw_weather[raw_weather["knowledge_time"] <= forecast_start]
forecast_start ist der Zeitpunkt, zu dem die Prognose erstellt wird. Daher ist ein historischer Wert, der um forecast_start veröffentlicht wurde, für ein Modell, das genau in diesem Moment laufen muss, nicht bekannt. An der Grenze ergibt sich eine Abweichung um eins, und keine Kennzahl im Backtest hätte uns dies jemals verraten.
Lassen Sie uns das Problem beheben, indem wir ein Zeichen entfernen:
knowable = raw_weather[raw_weather["knowledge_time"] < forecast_start]
Leakage checks for forecast window [2026-03-01, 2026-03-31]
  [backtest.load_raw_weather] leak check:   PASS
  [backtest.load_raw_weather] sanity check: PASS
  [backtest.load_raw_target] leak check:   PASS
  [backtest.load_raw_target] sanity check: PASS
Dies war ein bewusst einfach gehaltenes Beispiel. Ihre Merkmalstransformation sieht wahrscheinlich komplexer aus – mit Merkmalen, die voneinander abhängen, aus Rohdaten abgeleiteten konstruierten Merkmalen und so weiter. In diesem Fall ist es entscheidend, sich auf einen automatisierten Mechanismus zur Erkennung von Datenlecks zu verlassen.
Ausführung in der CI
run_leakage_checks gibt eine einfache Liste von Dictionaries zurück – das ist alles, was wir brauchen, um das Ganze in einen Test umzuwandeln, der bei jedem Commit ausgeführt wird:
def test_pipeline_does_not_leak():
    results = run_leakage_checks(WINDOW)
    assert all(r["sanity_check_passed"] for r in results), "perturbation never reached the model"
    assert all(r["leak_check_passed"] for r in results), "ouch!"
Fazit
Das frühzeitige Erkennen von Datenlecks ist ein entscheidender Schritt beim Aufbau zuverlässiger und vertrauenswürdiger Modelle für maschinelles Lernen. Das Vertrauen in Backtesting-Ergebnisse sollte nicht nur auf einer sorgfältigen Gestaltung der Pipeline und einer gründlichen Code-Analyse beruhen, sondern auch auf einer empirischen Analyse mit einem datengestützten Ansatz. Durch die Integration in die CI/CD-Pipeline lassen sich Datenlecks bereits auf Commit-Ebene erkennen, bevor es zu spät ist.
Photo by Yuriy Vertikov on Unsplash
Verfasst von

Eduardo Gonzalez Lopez de Murillas
Machine Learning Engineer


Contact