


Blog
Drei Dinge sind in Pandas 3 nun einfacher geworden
Garantiertes „Copy-on-Write“? Standard-Zeichenfolgen-Datentypen? Neues Objekt „pd.col()“? Lernen Sie diese Verbesserungen der Benutzerfreundlichkeit in pandas 3.0 kennen!

Keine Sorge … die neue Version von Pandas 3 bietet Ihnen alles, was Sie brauchen
Pandas 3.0 ist endlich da! Und was bringt es mit sich? Eine Reihe von Änderungen, die Ihnen das Leben spürbar erleichtern werden.
Nun gut, nichts, was Sie dazu bringen würde, Ihre gesamte berufliche Laufbahn zu überdenken (so dramatisch ist es nun auch wieder nicht), aber jene Verbesserungen der Lebensqualität, bei denen Sie sich fragen, wie Sie jemals ohne sie auskommen konnten.
Vielleicht haben Sie sich schon mit Spaltenreferenzen in Ihren Ketten herumgeschlagen, haben bei dem Datentyp „ object “ in Ihren Zeichenfolgen-Spalten die Augen zusammengekniffen oder wurden vom Gespenst von „ SettingWithCopyWarning“ heimgesucht … Nun, pandas hat Ihre Rufe erhört! Lassen Sie uns gleich einsteigen.
Das neue pandas-Objekt „ pd.col() “
Einer der Aspekte, die mir am Unterrichten von Programmieren besonders gefallen, ist es, die kleinen Eigenheiten der einzelnen Sprachen zu erklären. SQL muss in einer strengen Reihenfolge geschrieben werden, wird aber zur Laufzeit in einer anderen Reihenfolge gelesen. Der Zuweisungsoperator in R lautet „ <- “, obwohl „ = “ genauso funktioniert, sofern es sich nicht um einen Funktionsaufruf handelt (amüsanterweise funktioniert auch „ -> “, dies wird jedoch nie verwendet).
Und bei Pandas ist das nicht anders. Tatsächlich ist Pandas ein Hauptverursacher dieser „Hä?“-Momente. Es ist nicht so, dass diese Dinge seltsam wären oder nicht beabsichtigt wären. Sie erfordern lediglich, dass wir ein wenig anders darüber nachdenken, wie Pandas die Welt sieht und wie wir die Welt sehen.
Wenn Sie eine Spalte in einem pandas-DataFrame auswählen, ist der Code recht einfach:
employees['team']Wenn Sie nun jedoch versuchen, anhand dieser Spalte zu filtern – nehmen wir an, Sie möchten alle Mitglieder des Teams „Marketing“ anzeigen –, wird der Code ziemlich umständlich:
employees[employees['team'] == 'marketing']Beachten Sie, dass der Name des DataFrame an zwei Stellen angegeben werden muss: einmal bei der Festlegung der Filterbedingung und ein weiteres Mal, um anzugeben, auf welchen DataFrame diese angewendet werden soll. Die Spalte „ team “ existiert nur innerhalb von „ employees “ und nicht als eigenständige Variable im Namensraum von Python. Dies ist beabsichtigt: Im Gegensatz zu SQL oder R macht Python Spaltennamen bei der Auswertung von Ausdrücken nicht als Variablen verfügbar.
In pandas 2 stellte dies kein Problem dar, solange Sie sich an die Regeln hielten.
In pandas 2 war dies kein Problem, solange Sie sich an die Regeln hielten. Nun, zumindest solange, bis Sie Kettenoperationen durchführen wollten … was Sie, seien wir ehrlich, auch tun sollten! Es ist die eleganteste Art, mit pandas zu arbeiten.
Nehmen wir nun an, Sie möchten eine neue Spalte erstellen und anschließend nach dieser Spalte filtern. Wie können Sie das mit dem tun, was wir wissen? (Dass eine Spalte in einem DataFrame vorhanden ist, auf die verwiesen werden muss.)
Das folgende Beispiel funktioniert beispielsweise nicht – erkennen Sie, warum?
(
    employees
    .assign(tenure = (pd.Timestamp.today() - employees["start"]).dt.days/365)
    .loc[employees['tenure'] > 15]
)
Das Problem liegt in Zeile 4: Der Filter sieht genauso aus wie zuvor … .loc[employees['tenure'] > 15]… aber „ tenure “ ist im ursprünglichen „employees“-DataFrame nicht vorhanden. Daher kann auf diese Weise nicht darauf verwiesen werden.
In unserer Schulung „Python für die Datenanalyse“ sowie „Data Science mit Python“vermitteln wir den Teilnehmern den Umgang mit der Funktion „ lambda “. Damit können wir die Filtermethode angeben, anstatt den Filter physisch darzustellen. Das bedeutet, dass Sie den Namen des DataFrame nur einmal zu Beginn angeben müssen und ihn später in der Kette nicht mehr wiederholen müssen.
Sehen Sie sich jedoch einmal diesen Standardtext an:
(
    employees
    .assign(tenure = (pd.Timestamp.today() - employees['start']).dt.days/365)
    .loc[lambda df: df['tenure'] > 15]
)😮💨 Puh!
Nun ist der Code noch schwerer zu lesen, insbesondere da im Zuweisungsschritt auf „ employees “ verwiesen wird, dieser jedoch nicht in „ .loc “ enthalten ist.
Schauen wir uns einmal an, wie Pandas 3.0 diese Abfrage umschreibt:
(
    employees
    .assign(tenure = (pd.Timestamp.today() - pd.col('start')).dt.days/365)
    .loc[pd.col('tenure') > 15]
)
Auch wenn dies vielleicht nicht auf den ersten Blick ersichtlich ist, stellt die Ersetzung von ` lambda df: df ` durch ` pd.col ` eine wesentliche Änderung dar. Sie können nun ein Deferred-Objekt erzeugen, das die Spalte eines DataFrame darstellt, ohne das Spaltenobjekt direkt angeben zu müssen.
Dadurch wird Ihr Code:
- konsistent: Dieses Muster lässt sich auch bei anderen modernen Daten-Stacks wie Spark, Polars oder Ibis beobachten
- lesbar: „
pd.col“ ist ein leeres pandas-Objekt im Gegensatz zulambda df: df - skalierbar: Es ist nicht mehr erforderlich, mitten in der Verarbeitungskette nach allen DataFrame-Referenzen zu suchen
Diese Änderung wird gerne als 🍬 „syntactic sugar“ 🍬 bezeichnet – köstlich, aber nichts weiter als eine kosmetische Änderung
Wird der Code dadurch bei der Ausführung effizienter? Nun ja … nein. Die Bibliothek „pandas“ ist nach wie vor nicht darauf ausgelegt, die Leistung bei größeren Datenmengen zu optimieren. Diese Änderung ist das, was man gerne als 🍬 syntaktischen Zucker 🍬 bezeichnet – köstlich, aber nichts weiter als eine kosmetische Maßnahme.
Aber! Mit diesem Platzhalter hier bleibt vielleicht die Tür offen, um pandas zu einer optimaleren Bibliothek zu machen?
Standardmäßige Datentypen für Zeichenfolgen
„In Python ist alles ein Objekt.“ Das sagen die Leute besonders gern…
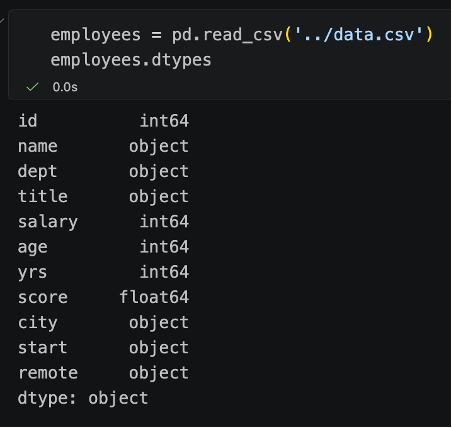
Aber! Haben Sie schon einmal einen DataFrame eingelesen, sich die Datentypen angesehen und sich gefragt: „Warum wurden meine Zeichenfolgen als Datentyp ‚ object ‘ interpretiert?“
Oder haben Sie sich die Spalten eines DataFrame angesehen und sich gefragt: „Was ist mit ‚Objekt‘ gemeint?“
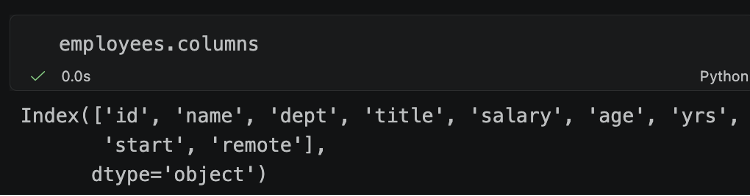
Das liegt daran, dass Pandas auf dem Typsystem von NumPy aufbaut, das aus einer Zeit stammt, als noch kein Bedarf an einem eigenen Datentyp für Zeichenketten bestand. NumPy ist für homogene Daten mit fester Größe konzipiert, bei denen jedes Element denselben Speicherplatz beansprucht … Ideal für Ganzzahlen, Gleitkommazahlen und Boolesche Werte – aber besteht eine Zeichenkette nun aus drei Zeichen („Hi!“) oder aus mehr Zeichen („hippopotomonstrosesquippedaliophobia“)?
„That second string“ ist übrigens die Bezeichnung für die Angst vor langen Wörtern … ironischerweise.
Machen Sie Platz, pandas 2 – es gibt eine neue Version … und diese verwendet standardmäßig Zeichenfolgen als Datentypen
Natürlich wurden in pandas 1.0 (2020) String-Datentypen in pandas eingeführt, doch diese wurden standardmäßig nicht geparst … man musste Strings ausdrücklich wünschen und es auch wirklich so meinen.
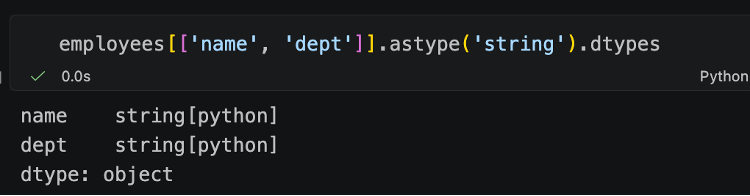
Treten Sie beiseite, Pandas 2 – es gibt eine neue Version … und diese verfügt standardmäßig über String-Datentypen.
Jetzt ist es so einfach wie 1, 2, read_csv:
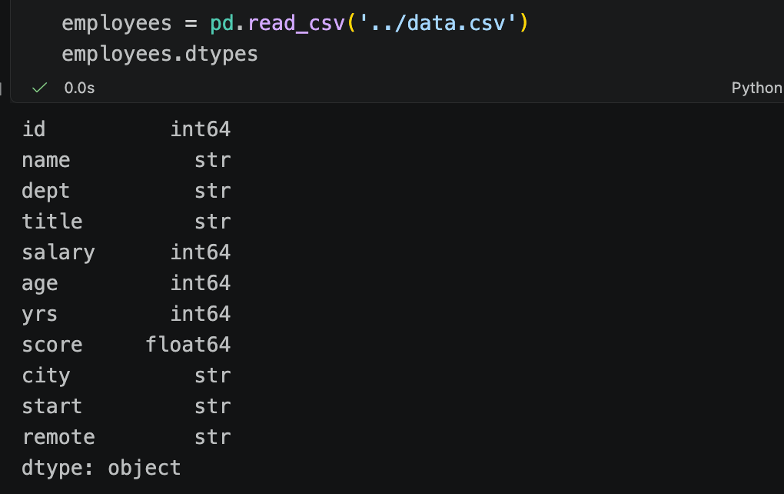
Wir sehen, dass all diese Zeichenfolgen-Spalten – „name“, „dept“, „title“ usw. – nun standardmäßig Zeichenfolgen-Datentypen sind.
Sie könnten meinen, dass es sich hierbei ebenfalls nur um eine nette Spielerei handelt, ähnlich wie bei unserem „Syntactic Sugar“ oben … doch es wird auch Leistungsvorteile geben, und zwar nicht nur marginale. Benchmarks mit verschiedenen DataFrames zeigen im Durchschnitt eine Speichereinsparung von über 50 % im Vergleich zum alten Datentyp „ object “. Doch es bleibt nicht beim Speicher… Die Operationen sollen 2- bis 27-mal schneller ablaufen. Genauer gesagt laufen „ groupby “-Operationen beim Datentyp „ string “ in der Regel 2- bis 4-mal schneller als beim Datentyp „ object “. Die Speichernutzung etwa um die Hälfte zu reduzieren, ist bei großen DataFrames von großer Bedeutung! Und die Geschwindigkeitsgewinne sind ein schöner, zusätzlicher Bonus.
Anmerkung: Eine nette Besonderheit dabei ist, dass die hier angezeigte Ausgabe eine Reihe ist – und der Datentyp der Reihe lautet „ object “. Sollten diese nicht standardmäßig Zeichenketten sein? Nun, nein … denn die tatsächlichen Werte in dieser Ausgabe sind keine Zeichenketten – es handelt sich um die nullfähige Datentypen von NumPy. Wir können dies erkennen, indem wir den Wert der ersten Zeile abrufen:
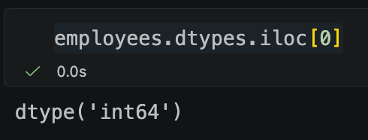
Es wird also weiterhin Fragen geben , was „object“ in dieser Ausgabe bedeutet, aber es werden definitiv weniger sein – und es werden keine Fragen mehr zu Ihren wichtigen Zeichenfolgen-Spalten sein!
SettingWithCopyWarning
Haben Sie diese lästige (und schwer zu erklärende) „SettingWithCopyWarning“ schon einmal gesehen?
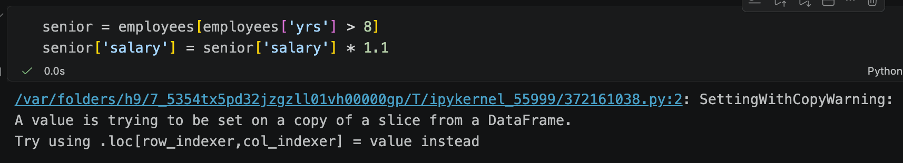
Ich fand es immer besonders schwierig, dies zu erklären. „ SettingWithCopyWarning “? Was bedeutet das überhaupt?
Was in pandas 2 hinter den Kulissen vor sich ging, war nicht nur verwirrend … es war auch inkonsistent
Die Logik ist klar … Ich möchte eine Teilmenge der Daten für Mitarbeiter erstellen, die länger als 8 Jahre im Unternehmen tätig sind, und anschließend das Gehalt um 10 % erhöhen. Warum erhalte ich eine Warnung, wenn ich eine Änderung an einer Kopie vornehme? Und wenn es sich um eine Warnung handelt … kann ich diese dann einfach ignorieren?
Was in pandas 2.0 hinter den Kulissen ablief, war nicht nur verwirrend, sondern auch inkonsistent. Die Bibliothek entscheidet, ob der Ausschnitt denselben Speicher wie der ursprüngliche DataFrame nutzen soll (d. h., es wird eine Ansicht erstellt) oder ob er eine eigene, unabhängige Kopie erhalten soll.
In diesem Fall wird die eigenständige Kopie erstellt. Dies lässt sich feststellen, indem man überprüft, ob sich die ursprünglichen Daten geändert haben.
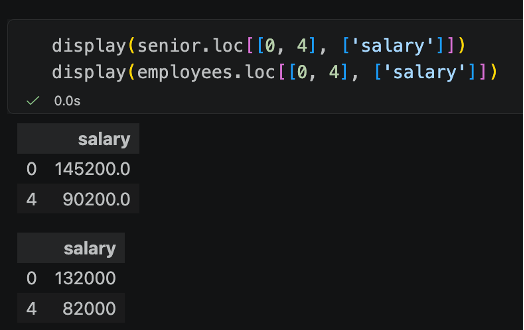
Beachten Sie jedoch, was im Folgenden geschieht, wenn wir einen anderen Ausschnitt erstellen … Nehmen wir beispielsweise an, wir wählen nur eine Spalte aus, um eine Pandas-Serie namens „ salaries “ zu erstellen, und verwenden diesen Ausschnitt dann, um den ersten Wert dieser Spalte durch „ -999999 “ zu ersetzen.

Zugegeben, der obige Code ist ziemlich seltsam … und ich gebe auch zu, dass ich im Produktionscode schon seltsamere Workarounds gesehen habe … doch die Logik hinter der hier verwendeten Syntax ist dieselbe wie im ersten Beispiel. Wir erstellen eine Teilmenge der Daten und modifizieren diese Teilmenge. Hinter all dem verbirgt sich jedoch, dass pandas Entscheidungen darüber trifft, welcher Speicher verwendet werden soll, was zu unerwünschten, oft unsichtbaren Nebenwirkungen führt.
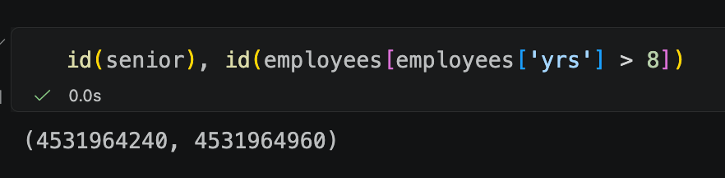
Dies lässt sich anhand der IDs der einzelnen Objekte weiter veranschaulichen. Beachten Sie, dass sich die ID „ id “ in Python im ersten Ausschnitt zwar ändert, im zweiten jedoch unverändert bleibt.
Ausschnitt 1:
Ausschnitt 2:
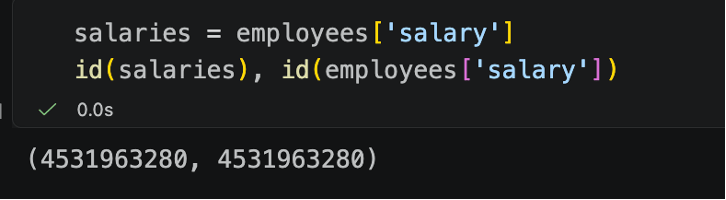
Die Entscheidung, Kopien zu erstellen, wird im Hintergrund von pandas getroffen, je nachdem, ob pandas einen zusammenhängenden Block des zugrunde liegenden Arrays zurückgeben kann, ohne diesen zu kopieren.
Moment mal … Sie wollen mir also sagen, dass bei gleicher logischer Absicht – der Änderung einer Teilmenge – unterschiedliche Ergebnisse auftreten können? Und dass dies nicht durch meine Logik bestimmt wurde, sondern durch die Speicherbeschränkungen von pandas?
In früheren Versionen war das Erhalten einer Kopie eines Slices nicht garantiert, doch in pandas 3.0 ist dies nun gewährleistet.
Das bedeutet, dass wir wie bisher alle möglichen unlogischen Codezeilen anwenden können.
Das ist jedoch nicht wegen der Pandas unlogisch, und jede überraschende Ausgabe ist auf unsere eigene Eingabe zurückzuführen – vielleicht müssen wir uns also einfach nur überlegen, was wir eigentlich erreichen wollen und warum.
Was hat uns Pandas 3.0 nun eigentlich gebracht?
Drei Neuerungen, die Ihren Code übersichtlicher und klarer machen und dafür sorgen, dass Anfänger nicht mehr so oft ratlos auf ihren Bildschirm starren:
- Lesbarer Code: „
pd.col()“ ersetzt den Standardcode „lambda df: df['col']“, wodurch verkettete Operationen endlich so aussehen, als hätte sie ein echter Mensch geschrieben - Übersichtlichere Datentypen: Zeichenfolgen werden nun standardmäßig als Zeichenfolgen interpretiert, sodass Sie nicht mehr erklären müssen, warum Ihre Spalte „
name“ eineobject - Konsistentes Verhalten: „Copy-on-Write“ ist nun bei Slices garantiert; Pandas trifft zur Laufzeit keine „heimlichen“ Entscheidungen mehr, sodass dieselbe Logik stets dasselbe Ergebnis liefert
Die Leistungsoptimierung ist nicht der ausschlaggebende Grund für diese Änderungen – pandas versucht nach wie vor nicht, Polars in puncto Leistung zu übertrumpfen. Doch all diese Änderungen tragen dazu bei, dass der Unterricht mit dieser Bibliothek Freude bereitet, dass sie leichter zu lesen ist und dass sie innerhalb des umfassenderen modernen Daten-Stacks konsistenter ist.
Kleine Dinge, großer Unterschied!
Möchten Sie diese Neuerungen in der Praxis erleben? Schauen Sie sich doch unsere kommenden Kurse an!
Verfasst von
Unsere Ideen
Weitere Blogs


Contact