Die meisten Gespräche über RAG beginnen an einem Punkt, der für Unternehmen sinnvoll ist, für persönliche Notizen jedoch kaum Sinn ergibt. Sie beginnen in der Regel mit Chunking-Strategien, Einbettungsmodellen, Vektordatenbanken, Rerankern, Aktualitätsgarantien, Berechtigungsgrenzen, Evaluierungswerkzeugen, Dashboards, Orchestrierung – und dabei bringt immer jemand das Thema GraphRAG zur Sprache.
Das sind echte, berechtigte Bedenken, wenn man eine Suchfunktion für große, unübersichtliche Korpora mit mehreren Nutzern entwickelt.
Ehrlich gesagt sind meine Probleme weniger umfangreich. Ich verfüge über ein Obsidian-Vault mit Rohaufzeichnungen, aufbereiteten Notizen, strukturierten Tags und Themen-Wikis, und ich möchte, dass Claude, Codex oder ein anderer Assistent diesen Kontext nutzt, ohne dass ich jedes Mal mehr als fünf Elemente in die Eingabeaufforderung einfügen muss.
Um ehrlich zu sein, war meine Überschrift ein wenig als „Clickbait“ gedacht; das, was ich tatsächlich entwickle, hat eine präzisere Bezeichnung als RAG. Anthropic bezeichnet die übergeordnete Disziplin als „Context Engineering“, und die spezifische Strategie, um die es hier geht, wird von ihrem Entwicklungsteam als „Just-in-Time-Context-Loading“ bezeichnet: Ein Agent speichert leichtgewichtige Verweise – in diesem Fall Dateipfade – und lädt den eigentlichen Inhalt zur Laufzeit, anstatt alles im Voraus zu verarbeiten. RAG ist eine Möglichkeit, dies umzusetzen. Einen Agenten auf einen gut organisierten Ordner auszurichten, ist eine andere Möglichkeit, und für meinen einzelnen Obsidian-Vault funktioniert dies hervorragend.
 Ich entwickle dies als echtes Obsidian-Plugin – mit „Nous“, Posteingang, Notizen, Tags, Wiki-Schwellenwert und allem, was dazugehört. Es befindet sich noch in einem frühen Stadium und ist an manchen Stellen noch etwas unausgereift, aber wenn Sie es lieber als Code statt als Blogbeitrag sehen möchten, dann finden Sie es dort.
Der Tresor ist die Architektur
Der nutzbare Bereich meines Tresors ist in vier Ordner unterteilt (Abbildung 1):
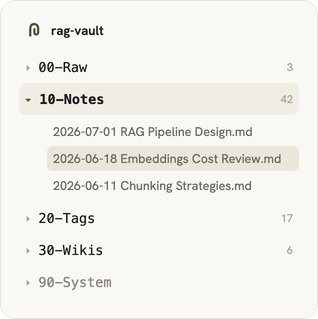
Abbildung 1. Die vier Arbeitsordner des Tresors in Obsidian.
Außerdem gibt es den Ordner „90-System/templates/“, der die Form der Notizen festlegt, doch das eigentliche Fachwissen befindet sich in den ersten vier Ordnern. „00-Raw“ steht für die Erfassung, „10-Notes“ für die normierte Ebene, „20-Tags“ für das kontrollierte Vokabular und „30-Wikis“ für die Synthese.
Falls das allmählich nach der „Medallion“-Architektur von Databricks klingt – Bronze, Silber, Gold –, so ist das ehrlich gesagt kein Zufall. Raw, Notes und Wikis lassen sich nahtlos darauf abbilden, wobei Tags als Referenzebene nebenstehend angeordnet sind. „Obsi-dallion“, wenn Sie einen Namen dafür suchen. Abbildung 2 zeigt die daraus resultierende Pipeline:
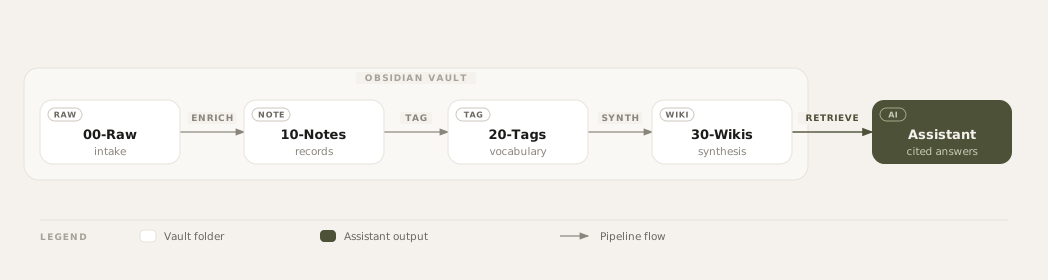
Abbildung 2. Von rohen Aufzeichnungen bis hin zu angereicherten Notizen, kontrollierten Tags, Themen-Wikis und Assistenzkontext.
00-Raw ist nicht die Wissensdatenbank
Der „Raw“-Ordner bleibt bewusst unspektakulär: Sprachnotizen, Besprechungsprotokolle, eingeklebte Gedanken, Fragmente aus dem Posteingang – alles, was dort landet, bevor es jemand genauer unter die Lupe genommen hat. Ein Protokoll ist keine Notiz. Es wurde weder bereinigt, mit einem Titel versehen, mit Tags versehen, verlinkt noch zusammengefasst; daher hat es nicht denselben Stellenwert bei der Suche wie eine angereicherte Notiz oder eine Wiki-Seite. Mein Assistent betrachtet „00-Raw“ als etwas, das es zu prüfen gilt, nicht als Ausgangspunkt. Rohmaterial kann unordentlich sein – es kann sich nur nicht als fertiges Wissen ausgeben, und erst eine bestimmte Kompetenz verwandelt es in solches.
10-Notes – Hier wird aus Erfassungen Daten
Diese Funktion liest alles, was in „00-Raw“ abgelegt wurde, und formatiert es in eine festgelegte Struktur um – zunächst die Kopfzeilen, dann die Hauptabschnitte. Im Grunde ist dies genau das, was Vektordatenbank-Pipelines mit jedem Datenblock tun, bevor dieser eingebettet wird – die strukturierte Extraktion ist ein altbekanntes Konzept, doch dank großer Sprachmodelle (LLMs) ist sie nun kostengünstig genug, um auch bei persönlichen Notizen angewendet zu werden. Die Kopfzeile bildet das Schema (Typ, Datum, Quelle, Projekt, Tags, Status); eine Besprechungsnotiz sieht wie folgt aus (Abbildung 3):
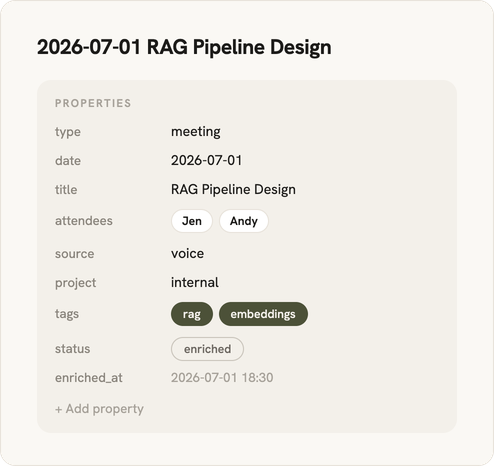
Abbildung 3. Der strukturierte Vorspann eines Sitzungsprotokolls.
Der Haupttext ist ebenso wichtig wie die Metadaten, wie in Abbildung 4 dargestellt:
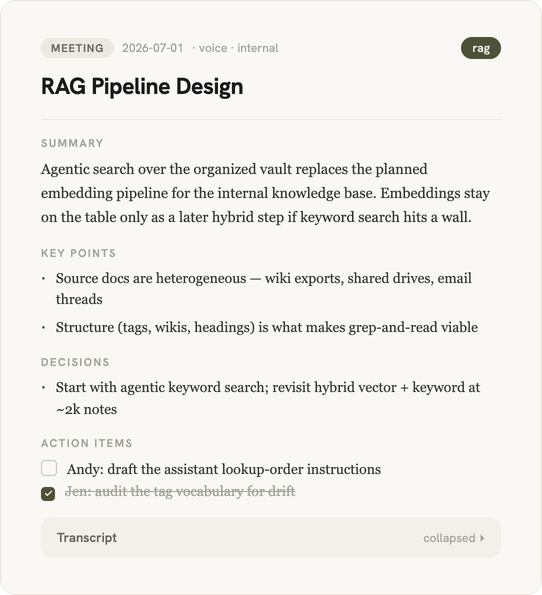
Abbildung 4. Der Hauptteil derselben Notiz: Zusammenfassung, Kernpunkte, Beschlüsse, Maßnahmen und Protokoll.
Dank der Kopfzeilen lassen sich die Notizen filtern, ohne dass die Datei geöffnet werden muss. Auch Überschriften spielen eine Rolle: „Zusammenfassung“ und „Transkript“ enthalten unterschiedliche Arten von Informationen; eine Suche, die Überschriften ignoriert, liefert daher leicht eine ganze Seite Transkript als Ergebnis, obwohl eine zweizeilige Zusammenfassung ausreichen würde. Und „Verwandte“ verknüpft die Notiz manuell mit anderen – was, wenn man es genau betrachtet, einem Knoten in einem Graphen entspricht, nur ohne die Graphdatenbank.
Ein Punkt, den ich hervorheben möchte: Ich lasse meinen Assistenten keine Struktur ableiten, die in der Notiz ohnehin bereits angegeben werden kann. Vektordatenbanken stützen sich aus demselben Grund auf Metadatenfilter – wenn ich das Datum, das Projekt, die Entscheidungen und die zugehörigen Notizen bereits kenne, gehört dies in das Markdown und muss nicht erst mithilfe von Embeddings neu ermittelt werden.
„20-Tags“ ist ein Vokabular, kein Hashtag-Sammelsurium
Jedes Tag ist eine eigene Markdown-Datei mit einer kurzen Definition (siehe Abbildung 5):
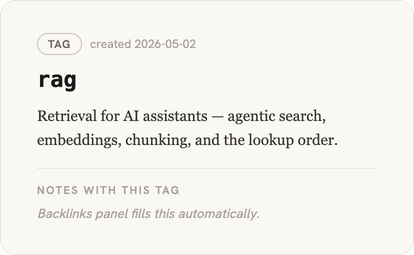
Abbildung 5. Eine Tag-Datei: eine einzeilige Definition sowie automatisch generierte Backlinks.
Genau diese einzeilige Definition macht Tags erst wirklich nützlich. Ein Punkt, den ich besonders hervorheben möchte, ist, dass sich ein Tag seinen Platz erst verdienen muss. Die gleiche Funktion, die die Notiz verfasst, weist ihr im selben Arbeitsgang auch Tags zu, und ich weise sie an, beim Hinzufügen neuer Tags äußerst zurückhaltend zu sein. Es prüft zunächst, was bereits vorhanden ist, und fügt ein Tag nur dann hinzu, wenn noch kein Tag das Konzept abdeckt, das Konzept tatsächlich im Mittelpunkt der Notiz steht und es plausibel ist, dass es später wieder auftaucht. In Zweifelsfällen verwendet es einfach das Tag, das dem Konzept am nächsten kommt.
Tags sind letztendlich der kostengünstigste Filter, über den ich verfüge. Eine Schulungsfrage beginnt mit dem Tag „Schulung“, eine Kundenfrage mit dem Tag „Kunde“. Wenn ein Thema sowohl ein Tag als auch ein Wiki hat, bildet das Tag die Abgrenzung und das Wiki die aktuelle Zusammenfassung.
30-Wikis ist die Syntheseebene
Mittlerweile hat der Archivbestand die Phasen der Erfassung, Bereinigung und Kennzeichnung durchlaufen, und in dieser nächsten Phase hört er auf, nur noch ein Haufen Notizen zu sein. Eine Wiki-Seite ist im Grunde genommen eine lebendige Zusammenfassung einer Gruppe von Quellnotizen, ähnlich dem, was Andy Matuschak als „Evergreen-Note“ bezeichnet – eine Notiz, die im Zuge eines besseren Verständnisses immer wieder überarbeitet wird, anstatt zum Zeitpunkt der Erfassung unverändert zu bleiben. Sie weist eine stabile Struktur auf, wie in Abbildung 6 dargestellt.
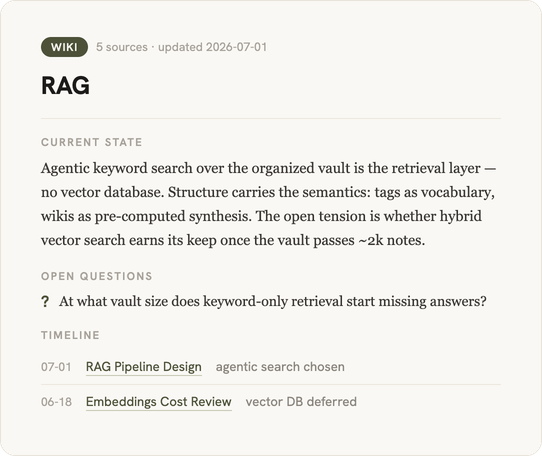
Abbildung 6. Eine synthetisierte Wiki-Seite zu einem Thema.
Die meisten privaten RAG-Konfigurationen überspringen diese Ebene und gehen davon aus, dass das Modell zum Zeitpunkt der Antwort alles neu generiert, wodurch die bereits im „Vault“ geleistete Arbeit verschwendet wird. Eine Wiki-Seite ist bereits eine Zusammenfassung zahlreicher Notizen zu einer für Menschen lesbaren Form.
Im folgenden Abschnitt gibt es eine zweite Funktion, die Wikis erstellt, und diese wird erst aktiviert, sobald sich genügend Notizen zu einem Thema angesammelt haben. Meine Faustregel lautet „vier“: Sobald ein Thema vier Besprechungsnotizen aufweist und noch kein Wiki vorhanden ist, ist es reif für eines. Dieselbe Funktion aktualisiert bestehende Wikis auf dieselbe Weise, sobald neue Notizen hinzukommen. Bei weniger als vier Notizen mache ich mir keine Mühe – ein Wiki ist zu diesem Zeitpunkt lediglich eine Unterhaltung, die mit Überschriften verziert wurde.
Was die Recherche betrifft, so habe ich folgende Reihenfolge: Wikis kommen vor Quellenangaben, der aktuelle Stand steht an erster Stelle, Belege an zweiter Stelle und die rohe Abschrift nur dann, wenn ich etwas überprüfen muss. Sie können sich das als eine Art „Reranker“ vorstellen, den ich einmal manuell berechnet habe, anstatt bei jeder Abfrage eine neue Bewertung vorzunehmen. Abbildung 7 zeigt die vollständige Reihenfolge.
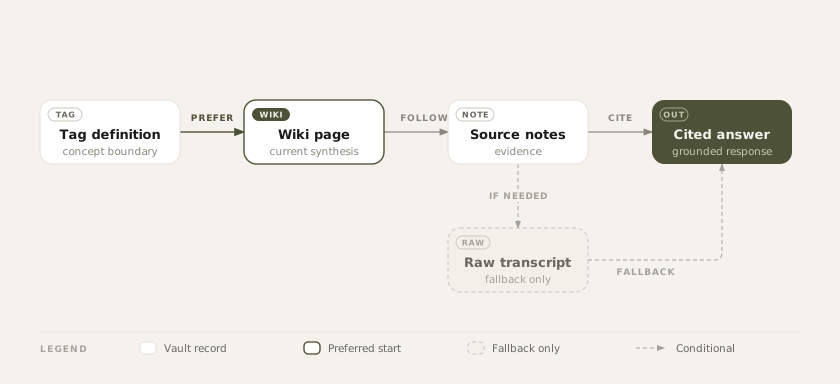
Abbildung 7. Die Reihenfolge der Abfrage durch den Assistenten: zunächst die Tag-Definitionen, Rohtranskripte nur bei Bedarf.
Diese Reihenfolge ist tatsächlich der entscheidende Punkt. Die Textgewinnung kann keine fehlerhafte Notiz korrigieren, fehlenden Kontext ergänzen oder die Richtigkeit von Angaben überprüfen – sie findet lediglich Text und übergibt ihn an das Modell. Eine unvollständige Erfassung wird ebenso flüssig beantwortet wie eine gut belegte, im gleichen Tonfall, mit derselben Sicherheit und ohne sichtbare Übergänge; daher entscheidet die Reihenfolge darüber, was zuerst angezeigt wird.
Es gibt kein Abrufsystem mehr, das aufgebaut werden könnte
Sobald der Speicher über diese Ebenen verfügt, muss kein Abrufsystem mehr aufgebaut werden. Claude und Codex lesen bereits Dateien, führen „grep“-Suchvorgänge durch und folgen Links – das ist ihre Aufgabe. Man muss ihnen lediglich mitteilen, wo sie suchen sollen und in welcher Reihenfolge:
Vault lives at <path>.
Check the tag definition first, then the topic wiki, then source notes.
Only open 00-Raw when the wiki and notes do not have the answer.
Cite file paths or Obsidian links.
Das ist die gesamte Integration: dieselbe Liste aus Absatz eins, abzüglich aller darin enthaltenen Elemente. Keine gehostete Vektordatenbank, kein lokaler Index, keine Synchronisationsplattform, kein Dashboard, kein separates Speicherprodukt, keine spezielle Abfragefunktion. Die Dateitools meines Assistenten bilden die Abfrageebene und werden direkt auf das Markdown angewendet, das bereits die maßgebliche Quelle darstellt. Es wird nichts erstellt, daher kommt es auch zu keiner Desynchronisation.
Auch dieser Mechanismus hat einen Namen: „Agentic Search“, manchmal auch als „Agentic Retrieval“ bezeichnet. Dabei nutzt ein Agent iterativ seine eigenen Werkzeuge – „grep“, „glob“ und „read“ – anstelle einer festgelegten Pipeline aus Einbettung und Abfrage. Es handelt sich dabei auch nicht um eine Nischenlösung. Claude Code wurde ursprünglich mit RAG und einer lokalen Vektordatenbank ausgeliefert, verzichtete jedoch darauf, sobald sich die „agentische Suche“ als leistungsfähiger erwies. Boris Cherny, der Leiter von Claude Code, erklärte, dass sie „alles übertroffen hat. Und zwar bei weitem.“ Er wies zudem darauf hin, dass die „agentic search“ die Probleme von RAG in Bezug auf Sicherheit, Datenschutz, Veralterung und Zuverlässigkeit umgeht – genau jene Bedenken, die den Betrieb von RAG so ressourcenintensiv machen. Amazon Science stellte fest, dass die agentische Stichwortsuche 94,5 Prozent der Genauigkeit von RAG erreichte, und zwar ganz ohne Vektorspeicher. Die in diesem Beitrag beschriebene „Vault“-Struktur dient dazu, diese Art der Suche kostengünstig zu gestalten. Tags, Wikis und Überschriften sind es, die es „grep-and-read“ überhaupt erst ermöglichen, einen Index zu ersetzen.
So arbeite ich tatsächlich Tag für Tag. Ich habe festgelegte Anweisungen, die Claude auf den Vault-Pfad verweisen – dasselbe Muster, das im obigen Block dargestellt ist –, und er überprüft diesen Pfad immer dann, wenn eine Aufgabe den Kontext benötigen könnte. Der Vault enthält das Wissen, und meinen Assistenten einfach darauf zu verweisen, ist die einzige Abrufebene, die ich tatsächlich benötige.
Die Stichwortsuche steht an erster Stelle
Die Stichwortsuche klingt zwar veraltet, passt aber ehrlich gesagt gut zur Struktur dieses Archivs. Embeddings sind dafür gedacht, wenn man die genauen Suchbegriffe nicht kennt; sie wandeln Text in Zahlen um und liefern Ergebnisse, die in etwa dasselbe bedeuten, auch wenn die Formulierung nicht übereinstimmt – und das ist wirklich nützlich, nur eben nicht für die meisten persönlichen Fragen. Meistens kenne ich bereits den Titel der Notiz, das Projekt, den Kunden, das Stichwort, das Datum oder die Überschrift, nach der ich suche – beispielsweise „Entscheidungen“, „Maßnahmen“ oder „Offene Fragen“. Wenn mir die Begriffe bereits im Kopf sind, findet die einfache Stichwortsuche sie schneller und zuverlässiger, als es eine Ähnlichkeitssuche jemals könnte. Genau hier setzen auch viele Beiträge von Praktikern an: Sie benötigen wahrscheinlich noch keine Vektordatenbank für Ihr RAG.
Die erste Anweisung, die ich meinem Assistenten erteile, lautet also nicht „Finde semantisch ähnliche Textabschnitte“, sondern es handelt sich eher um eine gefilterte Suche:
Find notes tagged training.
Prefer 30-Wikis.
Then search 10-Notes.
Return the Current state, Open questions, Decisions, and Sources sections.
Cite file paths or Obsidian links.
Was, ehrlich gesagt, ein weitaus kleineres Problem darstellt. Sollte die Stichwortsuche jemals zu kurz greifen, können Embeddings später einfach als zusätzlicher Schritt integriert werden, ohne dass ein komplett neues System erforderlich wäre: Führen Sie beide Suchvorgänge durch, kombinieren Sie die Ergebnisse, ordnen Sie sie nach Relevanz und übergeben Sie die besten Ergebnisse an das Modell.
keyword results
  + embedding results
  -> merge
  -> rerank
  -> cite notes
Ehrlich gesagt sind Embeddings lediglich eine Verbesserung einer bereits funktionierenden Suche und kein Ersatz für die zugrunde liegende Struktur. Auch eine unscharfe Suche benötigt im Hintergrund eine gut organisierte Struktur.
Vektordatenbanken dienen in erster Linie dazu, eine Frage gut zu beantworten: Was bedeutet so etwas wie das hier – und zwar über mehr Inhalte hinweg, als sich irgendjemand merken könnte? Das ist eine schwierige Aufgabe, und zwar eine wirklich reale, nur ist sie nicht meine. Ich verfüge bereits über den Bezeichner, ein Tag, einen Titel und ein Datum; daher ist der Rückgriff auf eine Ähnlichkeitssuche zusätzlich dazu kein Problem des Umfangs, sondern eine Diskrepanz hinsichtlich des Zwecks.
Es gibt noch einen weiteren damit verbundenen Impuls, dem man widerstehen sollte: einfach mehr Daten abzurufen, den gesamten Datensatz hineinzupacken und das Modell die Arbeit machen zu lassen. Mehr Kontext hilft – bis er es nicht mehr tut, ganz ehrlich. Chromas Untersuchungen zum „Context Rot“ haben ergeben, dass selbst leistungsstarke Modelle bereits lange bevor das Kontextfenster tatsächlich voll ist, eine um 30 bis 50 Prozent geringere Genauigkeit aufweisen, da das Verbergen der richtigen Antwort in einem Haufen lose zusammenhängender Notizen einfach nicht dasselbe ist wie deren direkte Bereitstellung. Das ist der eigentliche Grund, warum die Reihenfolge der Abfrage wichtig ist – nicht nur, um Token zu sparen, sondern auch, um zu verhindern, dass die Antwort des Wikis unter drei rohen Transkripten verloren geht, die niemand lesen musste.
Was dies meinem Assistenten bietet
Diese Konfiguration bietet meinem Assistenten ehrlich gesagt mehr als nur Text – sie stellt ihm ein Vertrauensmodell zur Verfügung. „00-Raw“ steht für wahrscheinlich unaufbereitetes Quellenmaterial, „10-Notes“ für einen angereicherten Datensatz mit Zusammenfassung, Metadaten und Links, „20-Tags“ für eine kontrollierte Konzeptabgrenzung und „30-Wikis“ für eine aktuelle Zusammenfassung zu einem Thema.
Das System reagiert also je nach Fund unterschiedlich: Es beginnt beim Wiki, sofern eines vorhanden ist; kennzeichnet den Status als „Entwurf“; gibt deutlich an, wenn eine Antwort nur auf einzelnen Notizen basiert; behandelt „00-Rohmaterial“ als unverarbeitet; und zeigt Meinungsverschiedenheiten zwischen den Notizen offen auf, anstatt sie zu beschönigen. Im Grunde derselbe Ansatz wie bei den Bewertungswerkzeugen eines echten RAG-Systems, nur von Hand statt über eine Kennzeichnungspipeline durchgeführt, wobei man weiß, inwieweit man einer Antwort vertrauen kann, bevor man sie weitergibt.
Das ist wirklich der eigentliche Gewinn, ganz ehrlich. Mein Assistent ruft nicht einfach nur mehr Kontext ab, sondern er ruft Kontext mit einer bestimmten Struktur ab.
Wo dies nicht funktioniert
Dieses System weist wirklich scharfe Kanten auf:
- Rückstand bei der Anreicherung. Das Erfassen ist so einfach, dass sich das Rohmaterial schneller ansammelt, als ich es tatsächlich verarbeiten kann. In „00-Raw“ ist das in Ordnung – dort soll es ja chaotisch zugehen –, doch es wird zum Problem, sobald eine unverarbeitete Erfassung wie eine fertige Notiz behandelt wird.
- Fehler bei der Anreicherung. Ehrlich gesagt kann die Software nach wie vor ein Transkript falsch interpretieren, eine falsche Entscheidung treffen oder das falsche Stichwort auswählen, und sobald dies in einer Notiz festgehalten ist, hat es das gleiche Gewicht wie jede korrekte Angabe.
- Tag-Drift. Ein kontrolliertes Vokabular bleibt nur dann kontrolliert, wenn neue Tags selten bleiben und alte nicht unbemerkt ihre Bedeutung ändern.
- Veraltete Wikis. Die Zusammenfassung kann hinter den Notizen zurückbleiben, die sie eigentlich zusammenfassen soll. Anhand des Aktualisierungsdatums und des Abschnitts „Quellen“ stelle ich dies im Nachhinein fest – im Grunde handelt es sich dabei um eine Aktualitätsgarantie, die ich manuell statt über ein Dashboard durchführe.
- Doppelte Erfassung. Ein Ordner „Duplikate“ ist besser, als so zu tun, als gäbe es sie nicht, doch das Suchsystem muss weiterhin erkennen, dass zwei nahezu identische Transkripte keine unabhängigen Belege darstellen.
- Grafikpflege. Ein Eintrag in „10-Notes“ oder „30-Wikis“ ohne externe Links ist ein Warnsignal. Unbearbeitete Aufzeichnungen können für sich allein stehen, angereicherte Einträge sollten dies jedoch nicht tun.
Die Diagrammansicht von Obsidian scheint der naheliegende Ort zu sein, um diesen letzten Punkt zu überprüfen, doch ehrlich gesagt habe ich festgestellt, dass sie größtenteils nur zur Zierde dient (Abbildung 8):
Abbildung 8. Die Diagrammansicht von Obsidian. Sieht gut aus, kann aber nicht viel.
Auf einem Screenshot sieht es gut aus – was, ehrlich gesagt, auch schon so ziemlich das Einzige ist, wozu es taugt. Ich nutze es nicht zur Navigation, und es spielt keine Rolle dabei, wie mein Assistent auf Fragen antwortet. Der Graph, der tatsächlich funktioniert, ist derjenige, der durch „Related Links“ und die Suchreihenfolge vorgegeben wird, nicht derjenige, der auf dem Bildschirm dargestellt wird. Das ist auch meine Antwort auf GraphRAG aus der Einleitung: In dieser Größenordnung besteht der nützliche Teil eines Wissensgraphen tatsächlich nur aus der Verknüpfungsstruktur, nicht aus einer Datenbank, die man abrufen und abfragen kann.
Der Kernpunkt
Die Suchfunktion ist nur so gut wie die ihr zugrunde liegenden Daten. Erfassen Sie die Daten in „00-Raw“, wandeln Sie sie in „10-Notes“ um, halten Sie die „20-Tags“ unter Kontrolle, synthetisieren Sie sie in „30-Wikis“ – und lassen Sie erst dann die Assistenten suchen. Lassen Sie Einbettungen erst später zum Tragen kommen, falls die Stichwortsuche, Tags und Links tatsächlich an ihre Grenzen stoßen.
Das Ziel war nie eine Miniatur-Unternehmenssuchplattform für eine einzelne Person, sondern lediglich nützlichere Notizen. Stellen Sie eine Frage, erhalten Sie die richtige Tag-Definition, die Wiki-Seite, zwei Quellnotizen und eine auf diesen Dateien basierende Antwort – das reicht ehrlich gesagt völlig aus. Die „Quelle der Wahrheit“ bleibt in Markdown, die Ordner geben Auskunft darüber, welche Art von Wissen jede Datei enthält, und mein Assistent erhält kostenlos einen besseren Kontext.
Klein, lokal, überprüfbar, langweilig – das war das Ergebnis. Wie sich herausstellte, handelt es sich dabei um agentische Suche und nicht um RAG, und genau das hatte ich mir gewünscht.
Verfasst von
Andy Ho
Unsere Ideen
Weitere Blogs


Contact