Die Nachfrageprognose scheint unkompliziert zu sein: Man verwendet historische Daten, um ein Modell anzupassen, und nutzt dieses Modell dann, um die zukünftige Entwicklung vorherzusagen. In der Praxis liegt ein Großteil der Schwierigkeit in den Entscheidungen rund um das Modell, die darüber entscheiden, ob vielversprechende Ergebnisse aus einem Notebook auch in der Produktion Bestand haben werden.
Vor kurzem bin ich im Rahmen eines Projekts zur Nachfrageprognose im Energiesektor mit vielen dieser Entscheidungen konfrontiert worden. Das Projekt hat Erkenntnisse aus früheren Prognosearbeiten bestätigt und mehrere neue Erkenntnisse zutage gefördert, von denen die meisten weit über diesen speziellen Bereich hinausreichen. Dieselben Grundsätze gelten für die Nachfrage im Einzelhandel, Logistikvolumina und andere zeitabhängige Größen. Einen umfassenderen Überblick über die damit verbundenen strategischen Entscheidungen – darunter auch die Frage, ob eine Prognselösung gekauft oder selbst entwickelt werden soll – finden Sie unter „Nachfrageprognose: Kaufen oder selbst entwickeln?“.
Dies ist der erste Artikel einer zweiteiligen Reihe, der sich auf die Experimentier- und Modellierungsphase konzentriert. Im Folgeartikel wird untersucht, was über das Notebook hinaus geschieht, und es werden die praktischen Schritte behandelt, die erforderlich sind, um ein Prognosemodell in den produktiven Einsatz zu bringen.
Schützen Sie sich von Anfang an vor Datenlecks
Datenlecks gehören zu den wichtigsten Problemen, die frühzeitig behoben werden müssen, da sie dazu führen können, dass ein Modell weitaus genauer erscheint, als es in der Produktion tatsächlich sein wird. Ein Datenleck tritt auf, wenn Informationen, die zum Zeitpunkt der Vorhersage nicht verfügbar wären, in die Trainingsdaten gelangen, was zu einer unrealistischen Bewertung führt, die oft erst nach der Bereitstellung erkennbar wird.
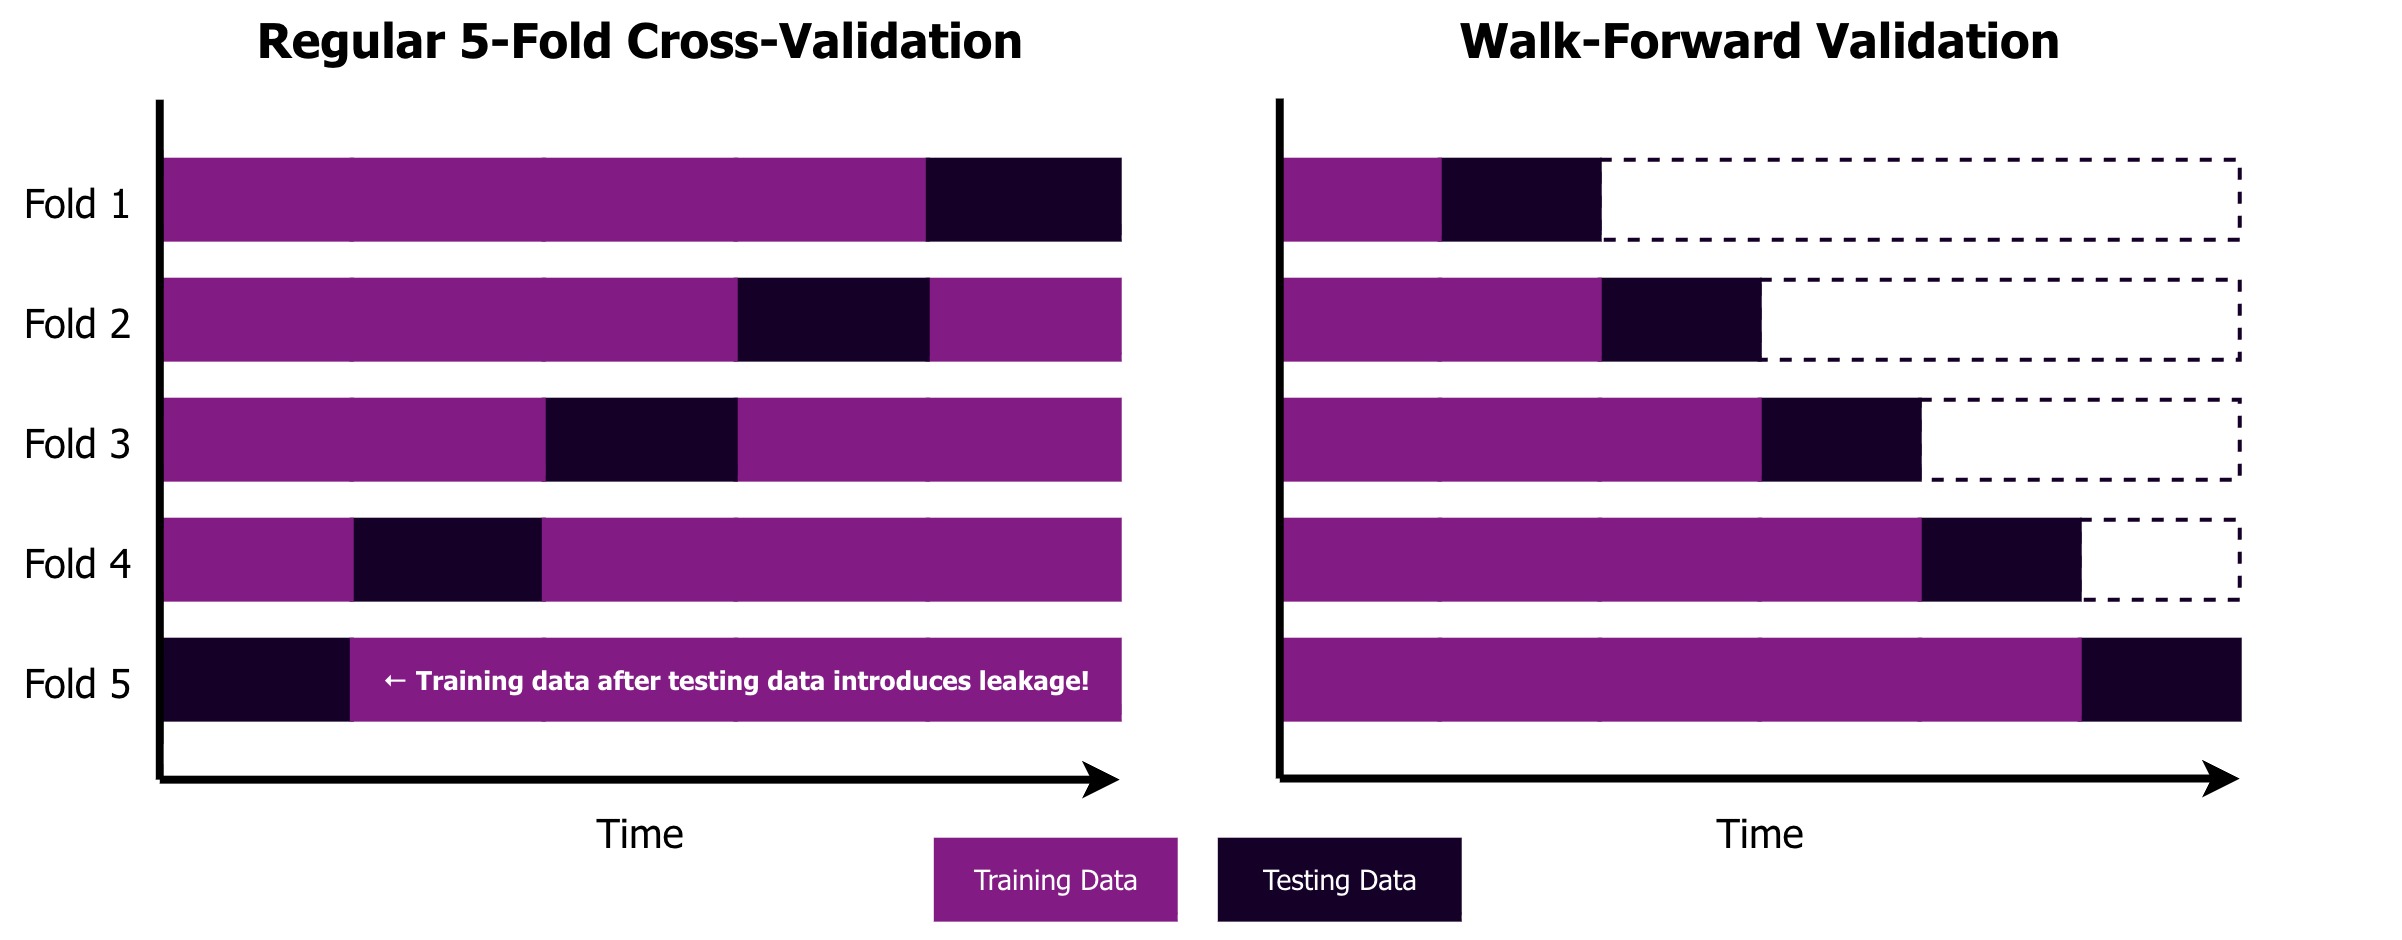
Eine häufige Ursache für Ungenauigkeiten bei Prognosen ist die zufällige Aufteilung in Trainings- und Testdaten. Das Mischen der Beobachtungen und das Zurückhalten von 20 % für Testzwecke ist bei vielen Problemen des maschinellen Lernens gängige Praxis, führt jedoch zu einer Störung der zeitlichen Struktur der Prognosedaten. Infolgedessen können Muster aus der Zukunft eine Vorhersage beeinflussen, die sich eigentlich nur auf die zu diesem Zeitpunkt verfügbaren Informationen stützen sollte, wodurch die Leistungsschätzung unzuverlässig wird.
Die geeignete Alternative ist die Walk-Forward-Validierung, auch bekannt als „Expanding-Window“- oder Zeitreihen-Kreuzvalidierung. Das Modell wird zunächst anhand eines ersten Blocks historischer Daten trainiert und anschließend auf den unmittelbar darauf folgenden Zeitraum angewendet. Anschließend wird der Grenzwert nach vorne verschoben, neu verfügbare Beobachtungen werden den Trainingsdaten hinzugefügt, und das Modell sagt den nächsten Zeitraum voraus. Durch die Wiederholung dieses Vorgangs wird sichergestellt, dass jede Bewertung widerspiegelt, wie sich das Modell im Produktivbetrieb verhalten wird.
Eine zeitabhängige Aufteilung allein verhindert nicht, dass „Leakage“ über die Merkmale selbst eindringt. So müssen beispielsweise gleitende Durchschnitte ausschließlich anhand von Werten berechnet werden, die vor der Vorhersage verfügbar waren, anstatt versehentlich Beobachtungswerte aus dem Prognosezeitraum einzubeziehen.
Bei anderen Funktionen muss zwischen historischen Werten und den Informationen unterschieden werden, die während des Prognosezeitraums verfügbar sein werden. So stehen beispielsweise historische Wetterbeobachtungen für das Training zur Verfügung, doch sollten zukünftige Bedingungen durch eine Wettervorhersage und nicht durch das tatsächlich beobachtete Wetter dargestellt werden. Dies ist in der Regel ein sinnvoller Ansatz, doch beachten Sie bitte, dass ein systematischer Unterschied zwischen beobachteten und prognostizierten Kovariaten die Genauigkeit beeinträchtigen kann. Im Gegensatz dazu sind im Voraus geplante Termine oder Buchungen möglicherweise bereits über den gesamten Prognosehorizont hinweg bekannt und können daher verwendet werden, ohne dass es zu Informationsverlusten kommt.
Eine praktische Methode zur Beurteilung besteht darin, jedes Merkmal an der Grenze zwischen Trainings- und Prognosezeitraum zu untersuchen. Stellen Sie fest, ob zukünftige Werte im Voraus bekannt sind, eine realistische Näherung wie beispielsweise eine Wettervorhersage erfordern oder nicht verfügbar sind und daher ausgeschlossen werden sollten. Die Anwendung derselben Regeln während der Validierung verhindert, dass zukünftige Informationen in die Bewertung einfließen, und liefert eine glaubwürdigere Einschätzung der Produktionsleistung.
Wählen Sie Kennzahlen aus, die die Geschäftskosten widerspiegeln
Standard-Regressionskennzahlen wie RMSE und MAE messen, wie stark Vorhersagen von der Realität abweichen. Sie sind nützlich für den Vergleich von Modellen, zeigen jedoch nicht, welche Kosten den Unternehmen durch Prognosefehler tatsächlich entstehen. Eine Senkung des RMSE um 10 % mag auf dem Papier beeindruckend wirken, doch ohne Verständnis für die betrieblichen Auswirkungen lässt sich nur schwer beurteilen, ob diese Verbesserung einen Monat Entwicklungsaufwand rechtfertigt.
Eine praktische Möglichkeit, diese Lücke zu schließen, besteht darin, neben statistischen Kennzahlen auch eine Kennzahl für die geschäftlichen Kosten zu definieren. Anstatt lediglich das Ausmaß von Prognosefehlern zu messen, schätzt diese Kennzahl deren finanzielle oder betriebliche Folgen ein. Die genaue Formulierung hängt vom jeweiligen Fachgebiet ab und sollte gemeinsam mit den Beteiligten entwickelt werden, die von diesen Folgen betroffen sind, um sicherzustellen, dass die Modellbewertung die Entscheidungen widerspiegelt, die durch die Prognose unterstützt werden sollen.
Diese Unterscheidung ist von Bedeutung, da Prognosefehler selten in beiden Richtungen die gleichen Folgen haben. Eine zu hohe Nachfrageprognose kann zu Überbeständen, ungenutzten Kapazitäten oder unnötigen Beschaffungen führen, während eine zu niedrige Prognose die Nichteinhaltung vertraglicher Verpflichtungen, teure Notfallkäufe oder Umsatzverluste zur Folge haben kann. Standardkennzahlen behandeln beide Fehler als gleichwertig, während eine Kennzahl für Geschäftskosten diese Asymmetrie erfassen kann, indem sie jedem Ergebnis unterschiedliche Strafpunkte zuweist.
Dies bedeutet jedoch nicht, dass statistische Kennzahlen vernachlässigt werden sollten, da sie nach wie vor wertvoll sind, um die Vorhersagequalität auf einheitliche und objektive Weise zu messen. Wirtschaftliche Kostenkennzahlen ergänzen diese, indem sie die Leistung in Begriffen ausdrücken, die für die Beteiligten von Bedeutung sind: Die Angabe, dass eine Modelländerung die erwarteten Betriebskosten um 50.000 € pro Monat gesenkt hat, bietet oft eine stichhaltigere Grundlage für Investitionen als die bloße Meldung einer geringen Verringerung des RMSE.
Beginnen Sie mit einer soliden Ausgangsbasis
Bei der Erstellung eines Prognosemodells ist es verlockend, sofort auf Gradient Boosting oder Deep-Learning-Architekturen zurückzugreifen. Ein besserer Ansatz besteht darin, mit der einfachsten Methode zu beginnen, die funktionieren könnte, und erst dann die Komplexität zu erhöhen, wenn die Ergebnisse dies rechtfertigen. Der erste Schritt besteht daher darin, eine Basislinie festzulegen, die ein Mindestleistungsniveau definiert, das fortgeschrittenere Modelle noch übertreffen können.
Bei der Prognose kann diese Basislinie verschiedene Formen annehmen. So kann eine naive Basislinie beispielsweise einfach den zuletzt beobachteten Wert übernehmen, während eine saisonale naive Basislinie den letzten Wert aus dem entsprechenden Zeitraum verwendet. Eine lineare Regression auf eine Handvoll offensichtlicher Merkmale, wie beispielsweise die Tageszeit, den Wochentag und die jüngsten Verzögerungen, kann ebenfalls zu einer gewissen Verfeinerung beitragen, ohne dabei große Komplexität einzuführen.
Diese einfachen Modelle zeigen auf, was sich mit grundlegenden zeitlichen Mustern erreichen lässt. Wenn ein sorgfältig abgestimmtes XGBoost-Modell eine naive Basislinie lediglich um 2 % übertrifft, rechtfertigen die damit verbundenen Wartungskosten, Schwierigkeiten bei der Fehlerbehebung und operativen Risiken möglicherweise nicht den zusätzlichen Aufwand.
Basismodelle behalten auch im Produktivbetrieb ihre Nützlichkeit, wo sie als Ausweichmodelle dienen und eine Plausibilitätsprüfung ermöglichen können, wenn das Primärmodell eine unplausible Prognose liefert. Das Prinzip besteht darin, die Komplexität schrittweise zu erhöhen, wobei jeder Schritt seinen Platz dadurch rechtfertigen muss, dass die damit verbundenen Verbesserungen der Vorhersagegenauigkeit oder des geschäftlichen Nutzens den zusätzlichen Wartungsaufwand überwiegen.
Unterscheiden Sie zwischen Nachfrage und beobachteten Ergebnissen
Das Ziel, das ein Prognosemodell erlernen soll, ist nicht immer die in den Trainingsdaten erfasste Variable. Umsatz, Verbrauch und abgewickelte Bestellungen stellen zwar beobachtete Ergebnisse dar, doch betriebliche Einschränkungen können dazu führen, dass diese die zugrunde liegende Nachfrage nicht genau widerspiegeln.
Das klassische Beispiel aus dem Einzelhandel ist ein Produkt, das nicht mehr vorrätig ist. Der Umsatz sinkt auf null, weil keine weiteren Einheiten mehr verkauft werden können – nicht, weil die Kunden kein Interesse mehr an dem Produkt hätten. Durch das Training direkt anhand dieser Beobachtungen lernt das Modell, dass die Nachfrage während der Lieferengpasse verschwunden ist. Ähnliche Zensierungseffekte treten auch in anderen Bereichen aufgrund verschiedener betrieblicher Einschränkungen auf.
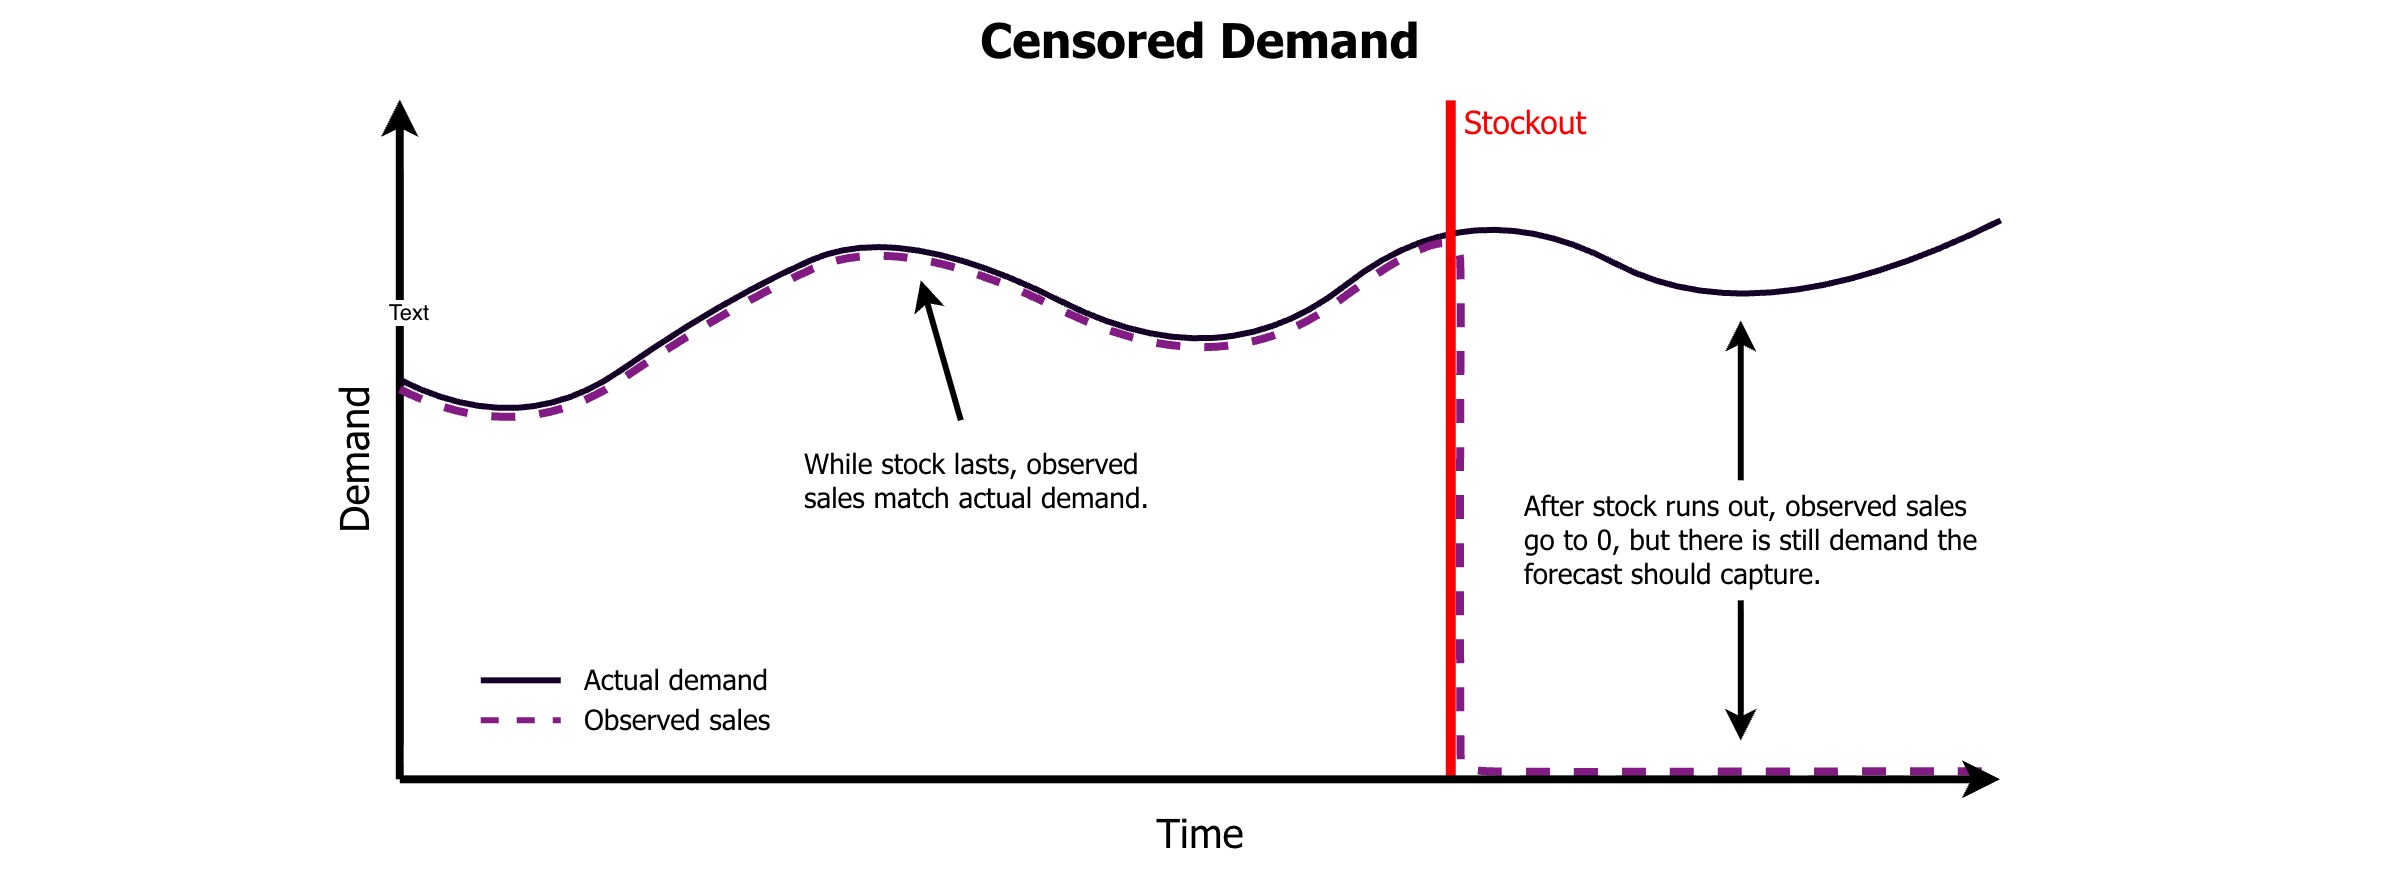
Wenn Engpassphasen identifiziert werden können, kann bereits eine grobe Korrektur das Ergebnis verbessern. Die Nachfrage könnte anhand aktueller Trends geschätzt werden, während Zusatzsignale wie Suchanfragen, Bestellversuche oder die Kapazitätsauslastung zusätzliche Hinweise auf ungedeckte Nachfrage liefern können. Wenn Lagerengpässe selten auftreten, kann der Ausschluss dieser Zeiträume eine praktikable Alternative sein. Beachten Sie jedoch, dass dies zu einer zu niedrigen Prognose führen kann, da Lagerengpässe häufig bei hoher Nachfrage auftreten. Der richtige Ansatz ist natürlich domänenspezifisch und hängt davon ab, ob ein genaueres Ziel die zusätzliche Komplexität rechtfertigt.
Der entscheidende Schritt besteht darin, diesen Unterschied zu erkennen und eine bewusste Entscheidung zu treffen. Die Verwendung des beobachteten Ergebnisses mag für einen bestimmten Anwendungsfall ausreichend sein, doch sollte es nicht allein deshalb zum Vorhersageziel werden, weil es die am leichtesten verfügbare Variable ist.
Das Modell an den geschäftlichen Kontext anpassen
Sobald das Prognoseziel klar ist, sollte der nachgelagerte Prozess, der die Prognose nutzt, festlegen, in welcher Form diese vorliegen soll. Planungs-, Terminierungs- und Beschaffungsprozesse finden auf bestimmten Detailebenen statt, und das Modell sollte auf die Informationen zugeschnitten sein, die diese Prozesse benötigen.
Ein häufiger Fehler besteht darin, die Modellierung mit einer höheren Auflösung durchzuführen, als es für die Entscheidung erforderlich ist. Zwar stehen möglicherweise stündliche Daten zur Verfügung, doch wenn die Prognose lediglich als Tages- oder Wochensumme genutzt wird, führt die Modellierung auf Stundenbasis zu zusätzlichem Rauschen, Rechenaufwand und Komplexität, ohne die Entscheidungsfindung zwangsläufig zu verbessern. Durch die Anpassung der Vorhersagegranularität an die Entscheidungsgranularität bleibt das Modell auf das zu lösende Problem fokussiert.
Auch das geschäftliche Umfeld sollte als Leitfaden für das Feature Engineering dienen. Kalendervariablen wie der Wochentag, der Monat und Feiertage bieten einen naheliegenden Ausgangspunkt, während domänenspezifische Ereignisse wie Wartungsfenster, saisonale Übergänge und Vertragslaufzeiten Muster erklären können, die sich mit generischen Zeitmerkmalen nicht erfassen lassen.
Bekannte Einschränkungen hinsichtlich der Ausgabewerte verdienen die gleiche Beachtung. Wenn Prognosen nicht negativ sein dürfen oder innerhalb bestimmter Betriebsgrenzen bleiben müssen, lassen sich diese Anforderungen über die Verlustfunktion, eine Nachbearbeitung oder eine einfache Begrenzung berücksichtigen. Durch die Einbeziehung solcher Einschränkungen wird verhindert, dass das Modell Vorhersagen liefert, die zwar statistisch plausibel, in der Praxis jedoch unmöglich sind.
Experimente systematisch nachverfolgen
Sobald die Experimentierphase beginnt, steigt die Anzahl der möglichen Konfigurationen rasch an, da Funktionen, Modellarchitekturen und Hyperparameter hinzugefügt werden. Ohne eine systematische Dokumentation wird es schwierig, Ergebnisse zu vergleichen oder festzustellen, welche Kombination aus Code und Einstellungen zu einem bestimmten Ergebnis geführt hat.
Setzen Sie MLflow oder ein ähnliches Tool zur Experimentverfolgung bereits in einer frühen Projektphase ein. Durch die Protokollierung der Parameter, Metriken und Artefakte bei jedem Durchlauf entsteht ein durchsuchbarer Verlauf der durchgeführten Versuche, der aussagekräftige Vergleiche ermöglicht, sobald die Anzahl der Experimente zunimmt.
Eine konkrete Empfehlung lautet, den Git-Commit-Hash zusammen mit jedem Experiment zu protokollieren, da die Einstellungen allein nicht ausreichen, um den Code zu identifizieren, der das Ergebnis erzeugt hat. Zusammen bilden die erfassten Parameter und der Commit-Hash eine zuverlässige Verknüpfung zwischen einem Experiment, seiner Konfiguration und der genauen Implementierung, die ausgewertet wurde.
Investieren Sie in das Konfigurationsmanagement
Die Nachverfolgung von Experimenten ist nur dann sinnvoll, wenn die Einstellungen für jeden Durchlauf einheitlich erfasst werden. Datenpfade, Feature-Toggles, Hyperparameter, Trainingsfenster und Prognosehorizonte werden häufig zunächst als fest codierte Werte oder verstreute Befehlszeilenoptionen festgelegt; dieser Ansatz lässt sich jedoch mit zunehmendem Projektumfang nur noch schwer verwalten.
Eine einfache Lösung besteht darin, von Anfang an eine Konfigurations-Dataklasse zu definieren und eine Bibliothek wie pydargs zu verwenden, um diese über die Befehlszeile zugänglich zu machen. Die Dataklasse dient dann sowohl als das vom Code verwendete Konfigurationsobjekt als auch als Grundlage für die Befehlszeilenschnittstelle, wodurch beide Darstellungen synchronisiert bleiben. In einem früheren Blogbeitrag wird pydargs ausführlicher behandelt.
from dataclasses import dataclass
from pydargs import parse

@dataclass
class ForecastConfig:
    """Forecasting pipeline configuration (will be logged to MLflow)."""

    model: str = "xgboost"
    lookback_days: int = 90
    include_weather: bool = True
    include_holidays: bool = True

config = parse(ForecastConfig)
Durch die Protokollierung dieser Konfiguration in MLflow zusammen mit dem Git-Commit-Hash werden sowohl die Einstellungen als auch der dahinterstehende Code jedes Experiments erfasst. Dadurch lassen sich erfolgreiche Durchläufe leichter reproduzieren, ohne den Entwicklungsworkflow wesentlich zu belasten.
Nachbereitung
Die Erkenntnisse in diesem Artikel konzentrieren sich bewusst auf die Grundlagen rund um das Modell und nicht auf die Modellarchitektur selbst. Ob Sie sich für XGBoost, ein LSTM, ein lineares Modell oder einen Transformer entscheiden, spielt zwar durchaus eine Rolle, doch die Architektur ist selten der einzige Faktor, der ein Prognoseprojekt einschränkt. Ein ausgeklügeltes Modell kann weder eine unkontrollierte Bewertung, ein schlecht definiertes Ziel, eine schwache Basislinie noch Metriken kompensieren, die keinen Bezug zum geschäftlichen Nutzen haben; ebenso wenig lässt es sich systematisch verbessern, wenn Experimente schwer reproduzierbar sind.
Die Berücksichtigung dieser Grundlagen erhöht die Glaubwürdigkeit der Modellleistung und bietet angesichts der zunehmenden Komplexität einen aussagekräftigen Maßstab, den es zu übertreffen gilt. Der Folgeartikel wird den Übergang vom Experimentier- zum Produktionsbetrieb thematisieren und dabei die Bereitstellungsinfrastruktur, die Überwachung sowie die betrieblichen Vorgehensweisen behandeln, die erforderlich sind, um ein Prognosemodell langfristig zuverlässig und nutzbar zu halten.
Verfasst von

Max van den Hoven
Machine Learning Engineer


Contact