AWS unterstützt Greengrass V2 offiziell unter Windows Server 2019 und 2022. Wir haben es unter Windows Server 2025 auf geklonten virtuellen Maschinen über eine Satellitenverbindung in einer Flotte getestet, bei der kein Fernzugriff gewährleistet war. Im Großen und Ganzen hat es funktioniert.
Greengrass selbst war nicht der schwierige Teil. Der schwierige Teil war alles drum herum: die Identität des Windows-Dienstes, die Zertifikatsinhaberschaft, der Zeitpunkt der Sysprep-Ausführung, der Bereitstellungslebenszyklus, Bereitstellungen bei geringer Bandbreite sowie die betriebliche Überprüfung, wenn niemand zuverlässig per Fernzugriff auf das Gerät zugreifen kann. Wenn Sie eine Edge-Bereitstellung in einer ähnlichen Umgebung planen, sollten Sie Identität, den Bereitstellungslebenszyklus und die Unzuverlässigkeit des Netzwerks von Anfang an als wichtige Gestaltungsfaktoren berücksichtigen.
In unserer Implementierung lief Greengrass V2 als „ NT AUTHORITY\SYSTEM “ über eine VSAT-Uplink-Verbindung mit 0,35 Mbit/s und einer Round-Trip-Latenz von ca. 580 ms in einer Seefahrzeugflotte, deren Schiffe den Großteil ihrer Zeit außerhalb des Hafens verbringen. Die Plattform ist im Produktivbetrieb auf Flottenebene im Einsatz.
In der AWS-Dokumentation werden einige dieser Aspekte separat behandelt: die Installation von Windows Greengrass, „ FleetProvisioningByClaim “, Komponentenrezepte und zentrale Geräte-APIs. Die Microsoft-Dokumentation befasst sich mit Windows EFS und Sysprep. Was wir jedoch nicht gefunden haben, war eine einheitliche Anleitung dazu, wie diese Komponenten im Zusammenspiel funktionieren. Und wenn man sie miteinander kombiniert, treten Lücken auf, die in keinem einzelnen Dokument aufgezeigt werden.
In diesem Beitrag werden die fünf Lücken erläutert, die bei unserer Einführung am wichtigsten waren:
- Was ändert sich, wenn Greengrass unter Windows ausgeführt wird?
- So gehen Sie sicher mit Zertifikaten bei Sysprep und auf geklonten Rechnern um.
- Wie lässt sich feststellen, wann „
FleetProvisioningByClaim“ tatsächlich beendet ist? - Welchen Einfluss hat die Satellitenbandbreite auf die Planung der Bereitstellung?
- So überprüfen Sie Vessels von AWS, wenn kein geräteseitiger Zugriff möglich ist.
Hintergrund: Warum es sich hierbei nicht um eine gewöhnliche Greengrass-Konfiguration handelte
Eine typische Greengrass-Einrichtung beginnt häufig mit einem Linux-basierten Gerät, einer stabilen Internetverbindung und einem Installationsablauf, bei dem davon ausgegangen werden kann, dass das Gerät während der Einrichtung und Fehlerbehebung erreichbar ist. Auch die offiziellen Beispiele und das Wissen der Community sind größtenteils auf Linux ausgerichtet. Dieses Modell ist für viele Fabriken, Gateways und Laborumgebungen sinnvoll.
Unsere Umgebung unterschied sich in mehreren wesentlichen Punkten.
Als Betriebssystem kam Windows Server 2025 zum Einsatz. Greengrass unter Windows läuft als Windows-Dienst, wobei der Kern als „ NT AUTHORITY\SYSTEM “ ausgeführt wird. Generische Komponenten werden unter einem konfigurierten Komponentenbenutzer ausgeführt, typischerweise „ ggc_user “, dessen Anmeldeinformationen im Credential Manager im SYSTEM-Kontext gespeichert werden müssen. Das bedeutet, dass der Zugriff auf das Dateisystem, die Prozessidentität, Umgebungsvariablen, geplante Aufgaben und die Lesbarkeit von Zertifikaten den Windows-Identitätsregeln folgen und nicht den POSIX-Annahmen.
Bei den Geräten handelte es sich um geklonte virtuelle Maschinen. Wir erstellten ein „Golden Image“, übertrugen es auf die Vessel-Hosts und schlossen die vesselspezifische Bereitstellung nach dem ersten Systemstart ab. Dadurch entstand eine klare Abgrenzung: Statische Software konnte fest in das Image integriert werden, während identitätsgebundene Komponenten erst erstellt werden durften, nachdem der Klon unter seiner endgültigen Maschinenidentität lief.
Es handelte sich um ein VSAT-Netzwerk. Eine Uplink-Geschwindigkeit von 0,35 Mbit/s bei hoher Latenz verändert die Bedeutung von „einfach neu bereitstellen“ oder „das Artefakt erneut herunterladen“. Teilweise Fortschritte sind normal. Ein kleiner operativer Fehler, der im Büro harmlos ist, kann bei einer Flotte einen ganzen Arbeitstag in Anspruch nehmen, bis die Situation wiederhergestellt ist.
Schließlich war der Zugriff auf die Geräte nicht gewährleistet. RDP könnte zu langsam, nicht verfügbar oder nicht autorisiert sein. Das Betriebsmodell musste davon ausgehen, dass Zustandsprüfungen von der AWS-Steuerungsebene ausgehen sollten und nicht über eine Anmeldung auf dem Schiff erfolgen.
Diese Einschränkungen erklären die Entwurfsentscheidungen im weiteren Verlauf dieses Beitrags: Es soll ausschließlich statische Software in das Golden Image integriert werden, Zertifikate und die Identität der einzelnen Instanzen sollen erst beim ersten Systemstart zugewiesen werden, Unterbrechungen der Bereitstellung sollen vermieden werden, Bereitstellungen sollen klein und unveränderlich gehalten werden, und die Verifizierung soll auf AWS-APIs basieren.
Was ändert sich, wenn Greengrass unter Windows ausgeführt wird?
Falls Sie aus einer Linux-Greengrass-Umgebung kommen, müssen Sie Ihre Denkweise zunächst ein wenig anpassen, damit der weitere Verlauf dieses Beitrags für Sie Sinn ergibt.
Greengrass unter Windows wird als Windows-Dienst ausgeführt. Der „Nucleus“ selbst wird als „ NT AUTHORITY\SYSTEM “ ausgeführt. Generische Komponenten werden als konfigurierter Komponentenbenutzer ausgeführt, in der Regel als „ ggc_user “ – ein lokales Konto, das Sie erstellen und im LocalSystem Credential Manager registrieren (in der Regel über PsExec, da die Anmeldeinformationen für den Greengrass-Dienst im SYSTEM-Kontext lesbar sein müssen). Einzelne Lebenszyklusschritte können mit dem Befehl „ RequiresPrivilege: true “ wieder auf die Identität des Kerns zurückgreifen, wenn sie außerhalb des Komponentenbenutzers ausgeführt werden müssen.
Eine Komponente, die unter Ihrer Administratorsitzung funktioniert, kann zur Laufzeit unter „SYSTEM“ fehlschlagen, und umgekehrt gilt dasselbe. Die praktische Regel lautet: Wenn Greengrass die Komponente ausführt, testen Sie sie mit der Identität, die Greengrass verwenden wird. Ein erfolgreicher Lauf als Administrator ist zwar für die Fehlersuche hilfreich, stellt jedoch keinen Beweis dafür dar, dass die Edge-Laufzeitumgebung ordnungsgemäß funktioniert.
Eine kleine, Windows-spezifische Falle stellte das Rezeptmodell dar. In den von uns getesteten Versionen verhielten sich mehrzeilige „ Script “-Blöcke wie separate „ cmd.exe “-Aufrufe pro Zeile. Das bedeutet, dass Variablen, „ cd “ und verkettete Befehle sich möglicherweise nicht so verhalten, wie sie es in einer Linux-Shell tun würden. Verketten Sie Befehle innerhalb einer einzigen Zeile mit „ && “ oder rufen Sie eine „ .cmd “- oder „ .ps1 “-Datei über „ artifacts/ “ als einen einzigen Befehl auf.
Zwei kleinere Punkte, die Sie berücksichtigen sollten, beide spezifisch für Windows:
- Python ist nicht Bestandteil von Windows Server. Wenn Sie Ihr Image unbeaufsichtigt erstellen und anschließend vor der Bereitstellung Sysprep ausführen, bleibt das „
PrependPath=1“-Flag des Python-Installationsprogramms beim Generalisierungsdurchlauf in unserem Ablauf nicht erhalten. Der vom Installationsprogramm geschriebene PATH wird zusammen mit anderen maschinenspezifischen Zustandsdaten gelöscht. Legen Sie den PATH explizit mit dem Befehl „[System.Environment]::SetEnvironmentVariable('Path', $newPath, 'Machine')“ in Ihrem Build-Skript fest. Bei interaktiven Installationen ohne Sysprep ist das PATH-Kontrollkästchen des Installationsprogramms ausreichend. Überprüfen Sie Python in einer neuen SYSTEM-Kontext-Shell. - Semantik der Konfigurationsaktualisierung. Wenn Sie die Berechtigung „
accessControl“ einer Komponente oder andere Rezept-Standardwerte zwischen verschiedenen Versionen ändern, behält ein bestehendes Gerät möglicherweise den alten lokalen Wert bei, es sei denn, die Bereitstellung enthält einen expliziten Eintrag „reset“ für diesen Schlüssel, gefolgt von „merge“. Das Symptom lautet: „Die Berechtigungsänderung scheint nicht wirksam zu werden.“ Die Lösung besteht darin, den Schlüssel „reset“ in die Bereitstellungsdaten aufzunehmen.
Stand Mai 2026 fällt Server 2025 selbst nicht unter die dokumentierte Support-Matrix von AWS. Bitte überprüfen Sie die Seite zu den von Greengrass V2 unterstützten Plattformen noch einmal, bevor Sie sich dafür entscheiden: Was heute nicht in der Matrix aufgeführt ist, könnte morgen bereits darin enthalten sein.
In unserer Bereitstellung funktionierten der Greengrass-Kern, die von uns verwendeten „ aws.greengrass.* “-Plugins (FleetProvisioningByClaim, LogManager, DiskSpooler), die MQTT-Veröffentlichung an AWS IoT Core sowie unsere benutzerdefinierten Python- und PowerShell-Komponenten jedoch wie erwartet. Die im Folgenden aufgeführten Fallstricke haben uns Zeit gekostet. Betrachten Sie dies als einen Datenpunkt aus der Praxis und nicht als Empfehlung, Server 2025 außerhalb der Support-Matrix zu betreiben.
Die meisten dieser Überraschungen betreffen die Identität. Die größte davon tritt auf, wenn Sie zum ersten Mal ein Zertifikat auf einem geklonten Rechner bereitstellen.
Wie bleiben Zertifikate nach der Sysprep-Ausführung erhalten?
Windows EFS (Encrypting File System) bindet die Entschlüsselung von Dateien an eine bestimmte Windows-Benutzeridentität. Eine als „SYSTEM“ verschlüsselte Datei kann von einer interaktiven Administratorsitzung nicht gelesen werden und umgekehrt. Genau diese Eigenschaft benötigen wir für Gerätezertifikate: Greengrass kann als „SYSTEM“ seinen eigenen privaten Schlüssel lesen, während ein bei der VM angemeldeter Bediener diesen nicht versehentlich kopieren kann.
Es war nicht unser Ziel, das Extrahieren des privaten Schlüssels von einem kompromittierten Host unmöglich zu machen. Wir wollten vielmehr den typischen Fehler im Support-Prozess vermeiden: Ein Mitarbeiter meldet sich an, entdeckt Zertifikatsdateien auf der Festplatte und kopiert diese ab. Wenn Ihr Bedrohungsmodell Personen einschließt, die Code als SYSTEM ausführen, den Host übernehmen oder das Gastbetriebssystem vom Hypervisor aus umgehen können, sind dateibasierte private Schlüssel die falsche Sicherheitsgrenze. Verwenden Sie stattdessen einen TPM-gestützten Schlüsselspeicher.
Damit dies in einer Flotte geklonter VMs funktioniert, befolgen Sie bitte zwei Regeln.
Regel 1: Verschlüsselungskontext. Verschlüsseln Sie unter der Identität, die Greengrass zum Lesen der Dateien verwenden wird. Wenn der Administrator den Befehl „ cipher /e privKey.pem “ ausführt, wird der Administrator zum autorisierten Entschlüsseler, und Greengrass verliert als „SYSTEM“ den Zugriff auf seinen eigenen privaten Schlüssel. Die Verschlüsselung sollte im SYSTEM-Kontext erfolgen. Nach der Verschlüsselung sollte unter „ cipher /c privKey.pem “ SYSTEM als einziger autorisierter Entschlüsseler für die Datei aufgeführt sein; einer Administratorsitzung, die versucht, dieselbe Datei zu lesen (beispielsweise mit dem Befehl „ type privKey.pem “), sollte der Zugriff verweigert werden. Dies setzt eine Standalone- oder Arbeitsgruppenkonfiguration ohne einen EFS-Datenwiederherstellungsagenten (DRA) in einer Domäne voraus (in einer Domäne kann der DRA Dateien unabhängig von der verschlüsselnden Identität entschlüsseln; überprüfen Sie daher Ihre Gruppenrichtlinie, bevor Sie sich auf diese Sicherheitskonfiguration verlassen).
Regel 2: Das richtige Timing. Aktivieren Sie EFS niemals vor der Ausführung von Sysprep. Sysprep standardisiert den Rechner und ändert Identitätsdaten, von denen EFS abhängt. Wenn Sie vor der Ausführung von Sysprep Daten im Golden Image verschlüsseln, kann die geklonte VM diese später möglicherweise nicht mehr entschlüsseln. Die Datei ist zwar noch vorhanden, und die Metadaten zeigen sie möglicherweise weiterhin als verschlüsselt an, doch Greengrass kann den privaten Schlüssel nicht lesen. Im Flottenmaßstab bedeutet dies, dass Maschinen ausgeliefert werden, die ihre eigenen Greengrass-Geräteanmeldedaten nicht lesen können.
 Die Grenze zwischen den beiden Zonen liegt dort, wo Sysprep ausgeführt wird. Alles, was vor dieser Grenze mit EFS verschlüsselt wurde, kann auf dem Klon nicht entschlüsselt werden. Die Verschlüsselung erfolgt nach der Bereitstellung des Zertifikats rechts von dieser Grenze als „SYSTEM“.
Die allgemeine Regel, die sich aus diesen beiden Punkten ergibt: Das „Golden Image“ enthält fest integrierte Software und statische Konfigurationen; identitätsgebundene Elemente werden auf den ersten Systemstart des Klons verschoben. Integrieren Sie die Java-Laufzeitumgebung, Python, Greengrass Nucleus, das „ FleetProvisioningByClaim “-Plugin sowie statische Konfigurationen für Regionen und Endpunkte. Halten Sie Gerätezertifikate und private Schlüssel, vorschiffsspezifische Bezeichnungen, EFS-verschlüsselte Daten sowie alles, was an die SID des Originalrechners gebunden ist, davon fern. Diese werden erst erstellt oder angewendet, nachdem der Klon unter seiner endgültigen Identität läuft. (Das Zertifikat, das das Plugin zur Authentifizierung verwendet, ist auf den Bereitstellungsbereich beschränkt und kann nach der Bereitstellung entfernt werden.)
Übertragen Sie das Image physisch oder während einer Verbindung im Büro auf die Host-Rechner; verwenden Sie niemals die Satellitenverbindung. In sehr langsamen Umgebungen wie der unseren kann die Übertragung einer typischen 30-GB-VHDX-Datei über VSAT Tage dauern: Das ist keine Bereitstellung, sondern ein Projekt. Bei schnelleren Verbindungen ist dies weniger problematisch.
Obwohl all dies bereits eingerichtet war, wurden bei unseren ersten geklonten Instanzen dennoch jeweils zwei Zertifikate ausgestellt. Die Ursache lag in einer Verzögerung von zwölf Sekunden innerhalb des Provisioning-Plugins.
Wann ist „FleetProvisioningByClaim“ tatsächlich abgeschlossen?
Wenn Sie eine Logik für den ersten Systemstart schreiben, die auf den Abschluss von „ FleetProvisioningByClaim “ warten muss – in der Regel, weil im nächsten Schritt das Zertifikat verschlüsselt, Greengrass neu gestartet oder das Schiff als bereit markiert werden muss –, achten Sie bitte auf das richtige Signal.
In unserem Fall war das zuverlässigste Signal die Zeile „remove from config“ in der Datei „ greengrass.log “, die das Plugin schreibt, nachdem es den Befehl „ RegisterThing “ ausgeführt und die Greengrass-Kernelkonfiguration aktualisiert hat, um sich selbst zu entfernen. Nicht das Vorhandensein der Zertifikatsdatei auf der Festplatte. Nicht die Protokolleinträge mit dem Text „publishing CSR“. Die Selbstentfernung des Plugins.
(Hinweis zu internen Statusdateien: In den von uns getesteten Nucleus-Versionen fungierte „ effectiveConfig.yaml “ als Momentaufnahme, die Nucleus beim Start und beim Herunterfahren erstellt, und nicht als live aktualisierte Statusdatei. Bitte überprüfen Sie diese Datei nicht regelmäßig. Die transaktionale Datei „ config.tlog “ ist die eigentliche Quelle für die Kernelkonfiguration, doch deren Auswertung ist aufwendig. Die Protokollzeile ist einfacher und reicht völlig aus.)
Dies ist von Bedeutung, da die Schritte des Plugins nicht atomar sind. „ FleetProvisioningByClaim “ schreibt zunächst das gerätespezifische Zertifikat und den privaten Schlüssel auf die Festplatte, führt anschließend „ RegisterThing “ aus und aktualisiert dann die Greengrass-Kernelkonfiguration, um sich selbst zu entfernen, sodass es nicht erneut ausgeführt wird. Die Zertifikatsdateien erscheinen bereits frühzeitig. Das Plugin ist erst fertig, wenn es die Konfiguration geändert hat.
Sollte Greengrass während dieses Zeitfensters neu gestartet werden, können Sie das Plugin mitten in der Sequenz unterbrechen. Beim nächsten Kernel-Start wird das Plugin noch in der Konfiguration vorgefunden, erneut ausgeführt, und es entsteht ein doppeltes Zertifikat, das demselben Objekt zugeordnet ist. So sieht ein unterbrochener Lauf in „ greengrass.log “ aus:
Zwölf Sekunden zwischen den Zertifikaten entsprechen der Zeitspanne zwischen „Dateien geschrieben“ und „Konfiguration geändert“. Dies ist das Zeitfenster, in dem ein falsches Abschlusssignal zu einem falschen Neustart führt.
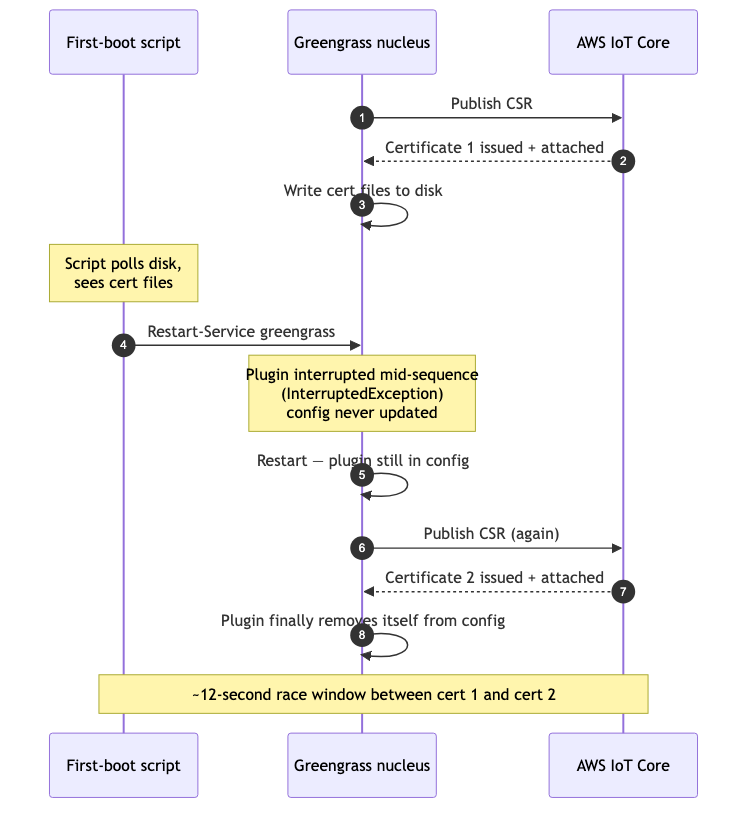 Von oben nach unten: Ein erstes Startskript, das das Vorhandensein einer Zertifikatsdatei als Abschluss betrachtet, löst letztendlich einen Neustart innerhalb des Lebenszyklus des Provisioning-Plugins aus, wodurch ein zweites Zertifikat für denselben Zweck erstellt wird.
Wir haben in der AWS-Dokumentation keine Hinweise gefunden, die den Lebenszyklus des Plugins als nicht atomar beschrieben hätten oder vor einem Neustart von Greengrass während der Bereitstellung gewarnt hätten. In unserem Fall war die fehlerhafte Aktion, die das Zeitfenster auslöste, ein vorzeitiger Aufruf von „ Restart-Service greengrass “ aus der Logik beim ersten Systemstart, der durch das Vorhandensein einer Zertifikatsdatei ausgelöst worden war. Durch das Entfernen des Neustarts wurde das Race-Problem behoben. In unserer Konfiguration wurde die EFS-Verschlüsselung (cipher /e /a) direkt angewendet, während Greengrass die Datei offen hielt; ein Neustart war von vornherein nicht erforderlich.
Dadurch mussten wir gar nicht mehr auf den Abschluss des Plugins warten. Sollten Ihre Logik für den ersten Systemstart jedoch erfordern, dass Greengrass neu gestartet, eine Folgekomponente ausgeführt oder eine Aktion ausgelöst wird, die davon abhängt, dass die Bereitstellung tatsächlich abgeschlossen ist, ist es nach wie vor wichtig, das richtige Abschlusssignal zu kennen.
Die allgemeine Regel, die über dieses spezifische Skript hinaus gilt: Betrachten Sie die Greengrass-Kernelkonfiguration als maßgebliche Quelle für die Fertigstellung des Plugins. Überwachen Sie die Datei „ greengrass.log “ auf die Zeile, die das automatische Entfernen des Plugins auslöst. Sobald diese Zeile erscheint, ist das Plugin fertiggestellt, und ein nachfolgender Neustart wird dessen Ausführung nicht mehr beeinträchtigen.
Identität, Zertifikate, Provisioning-Lebenszyklus: Dies sind Probleme, die Sie in einem „sauberen“ Büronetzwerk lösen können. Satelliten-Uplinks verändern die Bedeutung des Begriffs „sauber“.
Wie wirkt sich die Satellitenbandbreite auf Ihr Design aus?
Greengrass-Implementierungen funktionieren reibungslos, wenn das Edge-Gerät über eine schnelle und stabile Verbindung verfügt. Bei VSAT sieht die Sache anders aus.
Bei dieser Bandbreite und Latenz sowie bei zeitweiligen Verbindungsabbrüchen verschieben sich die Fehlermuster. Wiederholte Artefakt-Downloads erfolgen in Echtzeit. „Chatty“ AWS-API-Abläufe lassen sich schlechter skalieren, als die Durchsatzzahlen vermuten lassen. Ein teilweiser Fortschritt während einer Bereitstellung ist normal und keine Ausnahme. Eine Neubereitstellung, die im Büro problemlos funktioniert, kann dazu führen, dass eine große Flotte einen ganzen Arbeitstag lang in den Zustand der teilweisen Wiederherstellung nach der Bereitstellung versetzt wird.
Es folgen einige gestalterische Entscheidungen:
- Halten Sie die Artefakte der Komponenten klein und vergeben Sie ihnen unveränderliche Versionsnummern. Behandeln Sie eine veröffentlichte Version als unveränderlich; überschreiben Sie niemals das S3-Artefakt einer Version. Schiffe, die sich mitten in der Bereitstellung befinden, müssen in der Lage sein, dieselben Daten wie der Rest der Flotte abzurufen.
- Verwenden Sie einen persistenten MQTT-Spooler auf Festplatte. AWS stellt hierfür den „
aws.greengrass.DiskSpooler“ zur Verfügung, allerdings nur für Nachrichten, die über den Greengrass-MQTT-Pfad an AWS IoT Core veröffentlicht werden und innerhalb der konfigurierten Spool-Kapazität liegen. Legen Sie die Größe anhand Ihrer tatsächlichen Datenrate und der Ausfallzeit fest, die Sie tolerieren müssen. Wählen Sie keinen Standardwert und verlassen Sie sich nicht darauf, dass dieser ausreicht. - Führen Sie Änderungen schrittweise ein und bevorzugen Sie wenige, dafür aber umfangreichere geplante Änderungen. Häufige flottenweite Umstellungen vervielfachen die VSAT-Kosten und vergrößern den Umfang der Wiederherstellung bei Teilausfällen. Ein monatliches Rollup ist in der Regel praktischer als wöchentliche Hotfixes.
- Gestalten Sie den ersten Startvorgang so, dass er wiederholt werden kann. Es kann vorkommen, dass Geräte während des Bootstrap-Vorgangs die Verbindung verlieren. Der Bereitstellungsprozess sollte aus einem teilweisen Zustand heraus reibungslos fortgesetzt werden können. Alle irreversiblen Vorgänge, wie beispielsweise die Ausstellung von Zertifikaten oder die Registrierung von Geräten, erfordern eine sorgfältige Abwicklung im Lebenszyklus.
- Vermeiden Sie Arbeitsabläufe, die die Verwendung von Remote Desktop erfordern. Sollte die Diagnose der Bereitstellung nur durch eine Anmeldung bei der VM über die Satellitenverbindung möglich sein, ist diese nicht für dieses Netzwerk ausgelegt.
Ein praxisorientiertes Gespräch zur Dimensionierung des DiskSpoolers sollte folgende Punkte abdecken: die Anzahl der Nachrichten pro Sekunde, die durchschnittliche Nutzdatengröße, Rohdaten im Vergleich zu aggregierten Daten, die längste Ausfallzeit, die Sie bereit sind zu puffern, was geschieht, wenn der Spool voll ist, und ob Dashboards Live-Daten benötigen. Die gleichen Antworten bestimmen Ihre Toleranz gegenüber Zertifikatsrotationen und anderen Vorgängen, die zu einem kurzzeitigen Neustart von Komponenten führen. Wenn der Spool Daten während der Übertragung schützt, ist ein kurzes Wartungsfenster akzeptabel. Ist dies nicht der Fall, führt ein zweiminütiges Fenster bereits zu Datenverlust.
Das Ziel besteht nicht darin, VSAT zuverlässig zu machen. Das Ziel besteht vielmehr darin, die Plattform „langweilig“ zu gestalten, wenn VSAT unzuverlässig ist.
Sollte das Netzwerk so unzuverlässig sein, dass Sie das Gerät manchmal überhaupt nicht erreichen können, benötigen Sie eine Möglichkeit zur Überprüfung der Flotte, die nicht davon abhängt, dass das Gerät erreichbar ist.
Wie kann man einem Schiff vertrauen, das man nicht erreichen kann?
Selbst wenn Sie sich nicht auf dem Schiff anmelden können (RDP nicht verfügbar, langsam oder keine Berechtigung; der Bedienerarbeitsplatz läuft nicht unter Windows; PowerShell Direct ist ausgeschlossen), können Sie eine Greengrass-Flotte vollständig über AWS-APIs überprüfen.
Die Fragen, die Sie beantworten möchten, und die APIs, die diese beantworten:
- Ist das Kerngerät online und wurde es kürzlich gesehen?
greengrassv2 get-core device. - Ist die neueste Version bereits verfügbar?
greengrassv2 list-effective-deployments. - Sind die erwarteten Komponenten in den erwarteten Versionen installiert?
greengrassv2 list-installed-components. - Wird die Telemetrie tatsächlich empfangen? Ein IoT Core-Themenabonnement oder eine CloudWatch-Metrik, die aus den Zahlen der eingegangenen Nachrichten abgeleitet wird.
- Ist genau ein aktives Zertifikat mit dem System verknüpft?
iot list-thing-principalssowieiot describe-certificate.
Ein kleines Überprüfungsprogramm (ein Python-Skript mit boto3 oder ein Shell-Wrapper um aws iot und aws greengrassv2) führt diese Prüfungen für ein bestimmtes Objekt durch und gibt eine einseitige PASS/FAIL-Meldung aus. Es funktioniert von jedem Operator-Rechner mit AWS-Anmeldedaten aus, auf jedem Betriebssystem und ohne Zugriff auf die Geräte. Erstellen Sie es einmal und nutzen Sie es als maßgebliche Bereitschaftsprüfung.
Richten Sie die Alarme auf dieselben Signale aus. Bei VSAT sollten die Schwellenwerte großzügig genug bemessen sein, um Fehlalarme bei jedem Wetterereignis oder jeder kurzen Unterbrechung zu vermeiden, aber dennoch klar genug, um ein nicht sichtbares Schiff von einem verspäteten Schiff zu unterscheiden. Stunden, nicht Minuten.
Wenn Sie Greengrass-Protokolle an CloudWatch weiterleiten, konfigurieren Sie bitte die Stapelverarbeitung und eine angemessene Aufbewahrungsrichtlinie. Das Übertragen jeder einzelnen Protokollzeile über die Satellitenverbindung beansprucht Bandbreite, die eigentlich für die Telemetrie vorgesehen ist. Eine Stichprobenentnahme am Rand und das Hochladen aggregierter Zusammenfassungen sind in der Regel sinnvoller als das Streaming von Rohdaten aus der Standardausgabe.
Der Wandel in der Denkweise ist wichtiger als jede einzelne API. Der Betriebszustand lässt sich über die Steuerungsebene ablesen, nicht über das Gerät selbst. Der RDP-Zugriff auf ein Schiff ist ein Notfallwerkzeug, keine Routineüberprüfung.
Die Schnittmenge ist das Feld
Die meisten einzelnen Bausteine in diesem Stapel sind an anderer Stelle dokumentiert. Genau diese Kombination wird in der AWS-Dokumentation nicht als ein einziger Pfad behandelt. Jeder der oben genannten Abschnitte stellt eine Stelle dar, an der vernünftige Annahmen aus einem Bereich (Linux Greengrass, unterstützte Windows-Versionen, Ethernet-Konnektivität, geklonte Windows-Identitäten, atomare Bereitstellung) mit der Realität eines anderen Bereichs kollidierten.
Die wichtige Erkenntnis ist nicht, dass bei jeder Greengrass-Bereitstellung genau diese Entscheidungen getroffen werden müssen. Vielmehr geht es darum, dass die Edge-Architektur von der physischen und betrieblichen Umgebung rund um die Laufzeit geprägt wird. In diesem Fall bedeutete dies, dass Windows-Identität, die Bereitstellung beim ersten Systemstart, der Zertifikatsschutz, die VSAT-Bandbreite und die Fernüberprüfung ebenso wichtig waren wie der Greengrass-Komponentencode selbst.
Planen Sie von Anfang an mit Unterbrechungen. Die Schiffe werden Sie nicht zurückrufen.
Foto von Francesco Ungaro auf Unsplash
Verfasst von

İbrahim Can Gençel
Unsere Ideen
Weitere Blogs


Contact